
Weight Space'te Seyreklik: LLM Post-Training Nereye Dokunuyor?
Temel kaynaklar
Bu yazı aşağıdaki üç makalenin yakın okumasıdır. Her birinin tam metni, ekleriyle birlikte okunmuştur.
| Makale | Yazarlar | Tarih | Bu yazıda | |
|---|---|---|---|---|
| A | Understanding LLM Parameter Update Sparsity through the Lens of Fisher | Yufan Zhang, Sagnik Mukherjee, Hao Peng | 28 Eylül 2026 | Bölüm 4 |
| B | Not How Many, But Which: Parameter Placement in Low-Rank Adaptation | Arijit Sehanobish, Charles Lovering | 12 Mayıs 2026 | Bölüm 5 |
| C | The Surprising Effectiveness of Deleting Weights in LLM Post-Training | Jack Lu, Zhenbang Yang, Mike Lasby, Tejas Pote, Yani Ioannou, Mengye Ren | 7 Kasım 2026, NeurIPS 2026 | Bölüm 6 |
Tamamlayıcı kaynak: Sparks of Weight-Space Programming (Takehi, Teoh, Zhang, Khattab; MIT CSAIL blog yazısı, 2 Kasım 2026), Bölüm 7. Hakemli bir makale olmadığı için üç temel kaynakla aynı ağırlıkta ele alınmamıştır.
Yazıda üç tür içerik vardır ve birbirinden ayrı tutulmuştur: makalelerin söylediği (kaynak gösterilerek), bizim yorumumuz ("bizim okumamız" ya da "hipotez" diye işaretlenerek) ve bu yazı için yapılmış küçük ölçekli bir doğrulama deneyi (Bölüm 8).
Terim notu: Yerleşik teknik terimler çevrilmeden kullanılmıştır (weight space, attention, head, gate, residual stream, fine-tuning, pruning, baseline, forward pass, learning rate, seed, on-policy ve benzerleri). Gündelik karşılığı oturmuş kelimeler Türkçedir (ağırlık, katman, gradyan, maske, ödül, eğitim, unutma).
Bu yazı nasıl okunur
Yazı hem konuya sıfırdan başlayan hem de konuyu bilen okur için tasarlandı. Üç yol var:
15 dakika. Özet, Bölüm 9 ve Bölüm 8.9'daki bilanço tablosu. Ana tezi, çelişkileri ve yeni bulguyu verir.
Uygulayıcı. Bölüm 2.0, sonra 5, 8 ve 11. Hangi parametrelerin seçileceğini ve hangi deneyin önce yapılacağını verir.
Tam okuma. Baştan sona. Softmax, gradyan ya da Adam size yabancıysa Bölüm 2.0'ı atlamayın; takıldığınız terim için sondaki Sözlük'e bakın.
Özet
Bir dil modelini pekiştirmeli öğrenmeyle (RL) ya da kendi dağılımına yakın veriyle eğittiğinizde, milyarlarca ağırlığın çok küçük bir kısmı anlamlı biçimde değişir. 2026'da yayımlanan üç makale bu gözlemi üç ayrı yönden inceliyor ve birlikte okunduğunda şu tabloyu veriyor: post-training modele büyük bir bilgi yüklemiyor, modelin zaten sahip olduğu yeteneği kullanma biçimini ayarlıyor ve bu ayar az sayıda, yeri önceden tahmin edilebilir ağırlıkta yaşıyor.
Bu yazı o üç makalenin yakın okumasıdır; dördüncü bir kaynak tamamlayıcı olarak ele alınmıştır:
Neden seyrek? Zhang, Mukherjee ve Peng, diyagonal Fisher bilgisinin beklenen gradyana üst sınır koyduğunu gösteriyor. Çıktı dağılımını etkilemeyen ağırlığa gradyan da gelmiyor.
Hangi ağırlıklar? Sehanobish ve Lovering, LoRA'nın B matrisinde yalnızca birkaç bin girişi eğiterek RL altında yerin her şey olduğunu, SFT altında ise neredeyse hiç önemli olmadığını gösteriyor.
Ne kadar az? Lu ve arkadaşları hiçbir ağırlığın değerini değiştirmeden, ağırlıkların %0,05'inden azını silerek 7B ve üstü modellerde tam fine-tuning doğruluğuna ulaşıyor.
Gradyan şart mı? Takehi ve arkadaşları güçlü bir LLM'in ağırlıkları okuyup elle düzenleyebildiğine dair erken kanıtlar sunuyor.
Yazının makalelere eklediği dört şey var. Birincisi, üç makalenin hiçbirinin fark etmediği bir çelişki: A ve B'de hiçbir şey öğrenmeyen rastgele seyrek seçim, C'de tam fine-tuning ile başa baş (Bölüm 9.3). İkincisi, 75 bin parametreli bir modelde yapılmış bir doğrulama deneyi: iddiaların dördü tuttu, dördü tutmadı ve Fisher ile seçilen maskenin modele yeni bir şey öğretirken rastgele maskeden kötü olduğu ortaya çıktı (Bölüm 8). Üçüncüsü, A'nın Fisher sınırı ile B'nin gradyan skorunu Adam üzerinden birleştiren kısa bir türetim (Bölüm 9.4). Dördüncüsü, açık kalan soruları sınayacak altı deney (Bölüm 11).
Okuma notu: Bölüm 4-7'deki rakamların tamamı kaynaklardan, Bölüm 8'dekiler bu yazı için yapılan deneyden alınmıştır. Yorum ve çıkarım olan yerler metinde açıkça "bizim okumamız" ya da "hipotez" olarak işaretlenmiştir.
1. Giriş
Bir modeli fine-tune etmek dediğimizde aklımıza gelen resim genellikle şudur: optimizer bütün ağırlıkları biraz iter, model yeni bir yere taşınır. Tam fine-tuning (FFT) bu resmi doğru kabul eder ve 8B'lik bir model için 30 GB'lık yeni bir checkpoint üretir. LoRA resmi biraz daraltır: güncelleme düşük ranklı bir alt uzayda yaşar der. İkisi de güncellemenin ağırlıkların tamamına yayıldığını varsayar.
2025'te bu varsayımı bozan bir gözlem geldi. Mukherjee ve arkadaşları Hugging Face'teki hazır RL checkpoint'lerini kendi baz modelleriyle karşılaştırdı ve ağırlıkların %68,5 ile %96'sının hiç değişmediğini buldu. Bu, yedi farklı RL algoritmasında ve on farklı modelde tekrarlandı; herhangi bir seyreklik düzenlileştirmesi olmadan, kendiliğinden. Daha ilginci, değişen alt ağ farklı seed'lerde, farklı veride, hatta farklı algoritmalarda şansla açıklanamayacak kadar örtüşüyordu. Ve güncelleme seyrek olmasına rağmen düşük ranklı değildi: az sayıda ağırlık değişiyor, ama bu ağırlıklar matrisin neredeyse tüm alt uzayını geriyordu.
Bu gözlem üç soruyu aynı anda açar:
Mekanizma. Optimizer her ağırlığa gradyan hesaplıyor. Neden çoğuna sıfıra yakın gradyan geliyor?
Yer. Değişen ağırlıklar eğitimden önce tahmin edilebilir mi? Edilebiliyorsa, sadece onları eğitmek yeter mi?
Alt sınır. Gereken değişiklik ne kadar küçültülebilir? Ağırlığın yeni bir değer alması mı gerekiyor, yoksa sadece susturulması yeter mi?
2026'nın Mayıs-Kasım aralığında çıkan üç makale bu üç soruya sırayla cevap veriyor, dördüncü bir blog yazısı ise sorunun kendisini değiştiriyor: eğer davranışı belirleyen ağırlık kümesi bu kadar küçük ve bulunabilirse, onu bulmak için gradyana ihtiyaç var mı?
Neden önemli
Konu akademik bir merakın ötesinde dört pratik sonuç taşıyor.
Dağıtım maliyeti. Göreve özel değişiklik birkaç megabaytlık bir maskeye sığıyorsa, tek bir baz model üzerinde yüzlerce uzmanlaşmış varyant taşımak mümkün olur.
Unutma. Ağırlıkların çoğuna dokunulmuyorsa, modelin önceki bilgisi de büyük ölçüde korunur. Bu, continual learning için yıllardır aranan özelliktir.
Yorumlanabilirlik. Bir davranış değişikliği 10 bin ağırlıkta yaşıyorsa, o 10 bin ağırlığa bakmak 8 milyar ağırlığa bakmaktan çok daha gerçekçi bir iştir.
Küçük modeller ve kısıtlı donanım. Eğitilebilir parametre sayısı beş basamak küçülüyorsa, RL ile post-training tek bir tüketici GPU'sunda yapılabilir hale gelir.
Yazının planı
Bölüm 2 gerekli kavramları kurar: weight space, post-training rejimleri, transformer bloğunun projeksiyonları. Bölüm 3 bugünkü sonuçların köklerini pruning literatüründe arar. Bölüm 4-7 dört kaynağı tek tek, yöntem ve kanıt düzeyinde inceler. Bölüm 8 makalelerin ana iddialarını küçük bir modelde sıfırdan test eder. Bölüm 9 hepsini yan yana koyar ve uyuşmayan yerleri tartışır. Bölüm 10 buradan çıkan açık soruları, Bölüm 11 ise bunları sınayacak deneyleri sıralar.
2. Arka plan
Bu bölüm yazının geri kalanında kullanılan kavramları kurar: önce en temel beş kavram (2.0), sonra konuya özgü beş başlık (2.1-2.5). Konuya hakim okur doğrudan Bölüm 3'e geçebilir.
2.0 Ön bilgi: beş temel kavram
Bu alt bölüm konuya yeni başlayanlar içindir. Yazının geri kalanı bu beş kavrama yaslanır.
Ağırlık. Bir dil modeli, milyarlarca sayıyla yapılan bir çarpma ve toplama zinciridir. Bu sayılara ağırlık ya da parametre denir. Modelin bildiği her şey bu sayılarda saklıdır; eğitim, bu sayıları değiştirmekten ibarettir.
Logit ve softmax. Model her adımda sözlükteki her token için bir puan üretir; bu puana logit denir. Softmax logitleri olasılığa çevirir. Kritik özellik şudur: yalnızca logitler arasındaki farklar önemlidir. Bütün logitlere aynı sayıyı eklerseniz olasılıklar hiç değişmez. Bölüm 4'teki argümanın tamamı bu özellikten doğar.
Kayıp ve gradyan. Kayıp, modelin ne kadar yanlış olduğunu ölçen tek bir sayıdır. Gradyan, her ağırlık için şu sorunun cevabıdır: bu ağırlığı çok az artırırsam kayıp ne kadar değişir? N ağırlıklı bir modelin gradyanı N sayıdan oluşur. Gradyanı sıfır olan bir ağırlık kaybı etkilemiyor demektir ve eğitim ona dokunmaz.
Optimizer adımı ve Adam. En basit optimizer her ağırlıktan, gradyanının learning rate ile çarpımını çıkarır; büyük gradyan büyük adım demektir. Adam farklı çalışır: her ağırlığın gradyanını, o ağırlığın geçmişteki tipik gradyan büyüklüğüne böler. Sonuçta her ağırlık kabaca learning rate kadar adım atar ve adımın boyunu gradyanın büyüklüğü değil, yönünün adımdan adıma ne kadar tutarlı olduğu belirler. Bu ayrıntı Bölüm 9.3 ve 9.4'te belirleyici olacak.
Rank. Bir matrisin kaç bağımsız yönden oluştuğunu söyler. Rank-1 bir matris, tek bir sütun vektörü ile tek bir satır vektörünün çarpımıdır; içinde binlerce sayı olsa da tek bir yön taşır.
2.1 Weight space nedir
N parametreli bir sinir ağı, N boyutlu bir uzayda tek bir noktadır. 8 milyar parametreli bir model, 8 milyar boyutlu uzayda bir koordinattır; bu uzaya weight space (ya da parameter space) denir. Eğitim bu uzayda bir yörüngedir: rastgele bir noktadan başlar, kayıp fonksiyonunun yüzeyinde aşağı doğru yürür ve bir yerde durur.
Bu uzayı, sık sık karıştırıldığı iki komşusundan ayırmak gerekir:
| Uzay | Bir nokta neyi temsil eder | Tipik soru |
|---|---|---|
| Weight space | Modelin tüm parametreleri | Hangi ağırlıklar değişti, ne kadar? |
| Activation space | Tek bir girdi için bir katmanın çıktısı | Model bu girdide neyi temsil ediyor? |
| Function space | Modelin girdi-çıktı davranışı | İki model aynı şeyi mi yapıyor? |
Yorumlanabilirlik çalışmalarının çoğu activation space'te yaşar: bir girdi verilir, iç temsillere bakılır. Weight space'te çalışmak daha zordur, çünkü ağırlıklar girdiden bağımsızdır ve bir ağırlığın ne işe yaradığı ancak diğerleriyle birlikte anlam kazanır. Bu yazıdaki dört çalışmanın ortak yanı, soruyu doğrudan weight space'te sormalarıdır.
Weight space'in üç özelliği sonraki bölümlerde önem kazanacak.
Fazlalık. Weight space'ten function space'e giden harita bire bir değildir. Bir katmandaki nöronların sırasını değiştirirseniz weight space'te başka bir noktaya gidersiniz ama fonksiyon aynı kalır. Aynı davranışı veren çok sayıda nokta vardır. Sonuç olarak iki modelin ağırlıklarını karşılaştırmak, ancak ortak bir atadan geliyorlarsa anlamlıdır. Fine-tuning tam olarak bu durumdur.
Delta. Baz model ile fine-tune edilmiş model aynı noktadan başladığı için aralarındaki fark doğrudan ölçülebilir:
Bu farka task vector de denir. Ilharco ve arkadaşları 2022'de bu vektörlerle aritmetik yapılabildiğini gösterdi: toplayınca yetenekler birleşiyor, çıkarınca bir davranış siliniyor. Bu yazının bütün konusu aslında tek bir sorudur: delta nasıl bir nesnedir?
"Küçük" olmanın üç ayrı anlamı. Bir deltanın küçük olduğunu söylemenin birbirinden bağımsız üç yolu vardır ve literatürdeki karışıklığın çoğu bunları ayırmamaktan gelir.
| Ölçüt | Ne der | Hangi yöntem varsayar |
|---|---|---|
| Seyreklik | Sıfır olmayan giriş sayısı az | Maske tabanlı yöntemler, seyrek fine-tuning |
| Düşük rank | Delta az sayıda yönün birleşimi | LoRA ve türevleri |
| Küçük norm | Delta baz modele yakın | KL cezası, erken durdurma |
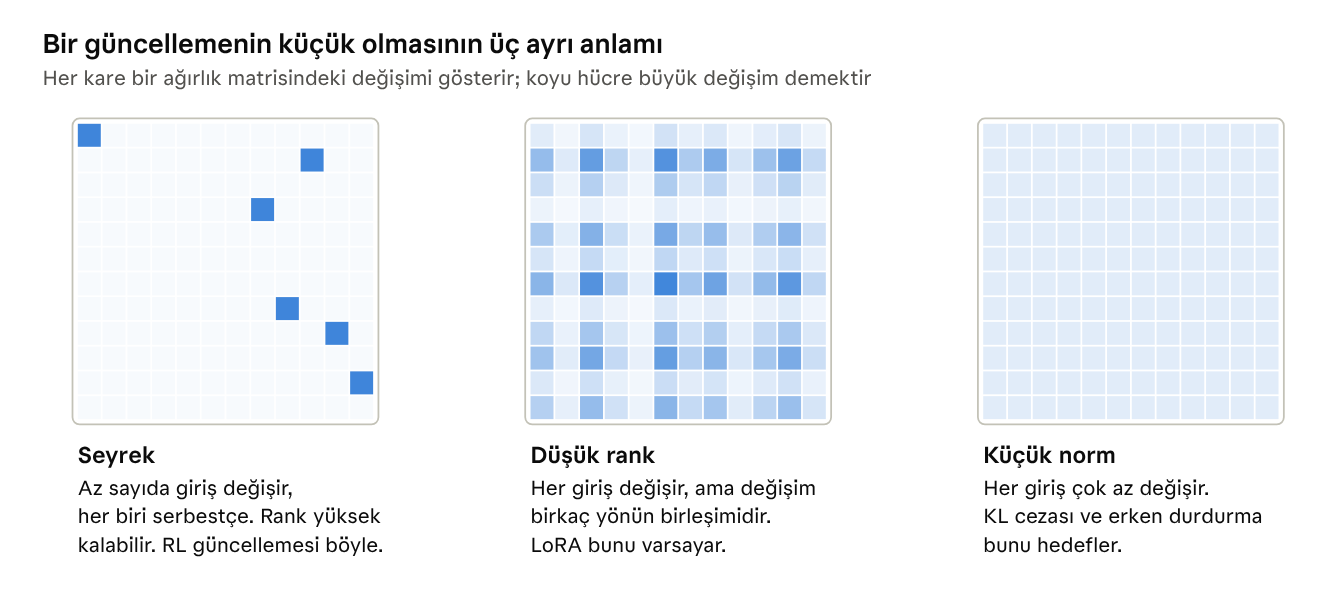
Bu üçü birbirini gerektirmez. Tek bir satırı değiştirilmiş bir matris hem seyrek hem düşük ranklıdır. Köşegeni değiştirilmiş bir matris seyrektir ama tam ranklıdır. Her girişine aynı küçük sayı eklenmiş bir matris rank-1'dir ama hiç seyrek değildir. Mukherjee ve arkadaşlarının gözlemi tam bu ayrımda duruyor: RL güncellemesi seyrek ama neredeyse tam ranklı. Yani LoRA'nın ön kabulü RL için yanlış eksende.
Üç ölçütün arkasında ortak bir sezgi var: intrinsic dimension (içsel boyut). Li ve arkadaşları 2018'de bir ağı rastgele seçilmiş düşük boyutlu bir alt uzayda eğitmenin, tam uzayda eğitmenin sonucuna şaşırtıcı derecede yaklaştığını gösterdi. Aghajanyan ve arkadaşları 2020'de bunu önceden eğitilmiş dil modellerine taşıdı ve ön eğitimin intrinsic dimension'ı düşürdüğünü buldu. LoRA bu fikrin mühendislik karşılığıdır. Bu yazıdaki çalışmalar ise aynı fikrin seyreklik eksenindeki versiyonunu kuruyor.
2.2 Post-training rejimleri
Ön eğitimden sonra yapılan her şeye post-training denir. Yazıdaki makaleler üç rejimi karşılaştırıyor.
Denetimli fine-tuning (SFT). Elde hazır gösterimler vardır, model bunların olasılığını artıracak şekilde cross-entropy ile eğitilir. Veri modelden bağımsızdır: modelin kendi üreteceği şeye benzeyebilir de benzemeyebilir de.
Doğrulanabilir ödüllü RL (RLVR). Model bir soruya kendi cevaplarını üretir, bir doğrulayıcı her cevaba ödül verir (çoğunlukla doğru ya da yanlış), ödülü yüksek cevapların olasılığı artırılır. Bugün en yaygın algoritma GRPO'dur: aynı soru için bir grup cevap örneklenir ve her cevabın avantajı, grubun ortalamasına göre hesaplanır. Ayrı bir value network'e gerek kalmaz. Dr. GRPO, DAPO ve BNPO bu şemanın normalizasyon ve kayıp ayrıntılarında farklılaşan türevleridir.
Tek bir adımı sayılarla görmek faydalı. Model bir soruya 8 cevap üretsin ve bunların 2'si doğru olsun. Grubun ortalama ödülü 0,25'tir. Doğru cevapların avantajı +0,75, yanlışların avantajı -0,25 olur. Güncelleme, doğru cevapları oluşturan tokenlerin olasılığını 0,75 ağırlığıyla artırır, yanlışlarınkini 0,25 ağırlığıyla azaltır. Şimdi iki uç duruma bakın: 8 cevabın hepsi yanlışsa ya da hepsi doğruysa bütün avantajlar sıfırdır ve gradyan da sıfırdır. RL yalnızca modelin bazen doğru, bazen yanlış yaptığı sorulardan öğrenebilir. Modelin hiç üretemediği bir cevabı RL ile öğretemezsiniz. Bu basit gözlem, yazının sonunda varılan sonucun tohumudur: RL yeni yetenek kurmaz, var olanın sıklığını ayarlar.
On-policy distillation (OPD). Öğrenci model kendi cevaplarını üretir, daha güçlü bir öğretmen model bu cevaplar üzerinde kendi olasılıklarını verir, öğrenci öğretmene yaklaştırılır. Klasik distillation'dan farkı, verinin öğretmenden değil öğrencinin kendisinden gelmesidir.
Bu üçünü ayıran en önemli eksen on-policy olup olmamaktır. RL ve OPD'de eğitim verisi modelin o anki dağılımından örneklenir. SFT'de veri dışarıdan gelir; modelin dağılımına yakınsa "near-policy", uzaksa "off-policy" denir. Bölüm 4'te göreceğimiz gibi seyrekliğin anahtarı tam olarak bu eksendir.
2.3 Transformer bloğunun anatomisi
Makalelerin "hangi ağırlıklar" sorusuna verdiği cevapları okuyabilmek için bir bloğun içindeki yedi doğrusal projeksiyonu tanımak gerekir. Llama ve Qwen ailelerinde her blok bir attention katmanı ve bir SwiGLU MLP'den oluşur.
| Projeksiyon | Yeri | İşlevi | Rol |
|---|---|---|---|
| Q, K | Attention | Hangi konuma bakılacağını belirler | Okuyucu |
| V | Attention | Bakılan konumdan ne alınacağını belirler | Okuyucu |
| O | Attention | Alınanı residual stream'e yazar | Yazıcı |
| Gate | MLP | Her ara nöronun ne kadar açılacağını belirler | İç hesap |
| Up | MLP | Ara nöronun taşıyacağı değeri hesaplar | İç hesap |
| Down | MLP | Ara nöronları residual stream'e yazar | Yazıcı |
SwiGLU MLP'nin formülü şöyledir:
Gate ve up aynı girdiyi okur, sonuçları eleman eleman çarpılır, down bu çarpımı residual stream'e geri yazar. Gate'in rolü çarpımsaldır: bir ara nöronun gate değeri sıfıra yakınsa up ne hesaplarsa hesaplasın o nöron susar. Bu ayrıntı Bölüm 6'da belirleyici olacak.
Parametre sayısı bakımından MLP baskındır. LoRA yerleşim makalesinin Qwen2.5 için verdiği dağılımda gate ve up'ın her biri LoRA-B parametrelerinin %38,4'ünü, Q, O ve down'ın her biri %7,1'ini, K ve V'nin her biri %0,9'unu tutuyor. Yani rastgele bir ağırlık seçerseniz dörtte üç ihtimalle gate ya da up'a düşersiniz.
2.4 LoRA ve B matrisi
LoRA, dondurulmuş bir ağırlık matrisi W'nin yanına düşük ranklı bir düzeltme ekler:
A rastgele başlatılır, B sıfırdan başlar; böylece eğitimin başında model baz modelle aynıdır. A girdiyi r boyutlu bir alt uzaya indirir, B bu alt uzaydan çıktı uzayına geri yazar. A dondurulursa B'nin her girişi "şu rastgele girdi yönünü şu çıktı nöronuna ne kadar bağla" sorusunun cevabı olur. Bölüm 5'teki makale tam bu girişleri tek tek sayar.
2.5 Fisher bilgisi
Fisher bilgisi, bir parametreyi biraz oynattığınızda modelin çıktı dağılımının ne kadar değiştiğini ölçer. Tam Fisher matrisi N x N boyutundadır ve hesaplanamaz; pratikte yalnızca köşegeni kullanılır. i numaralı parametre için:
Burada iki ayrıntı önemli. Birincisi, y modelin kendisinden örneklenir; etiket, ödül ya da öğretmen gerekmez. Fisher modelin kendi hakkında söylediği bir şeydir. İkincisi, parantezin içindeki türeve skor denir ve beklentisi sıfırdır; Fisher bu yüzden skorun varyansıdır. Bir parametrenin Fisher'ı küçükse, model hangi cevabı üretirse üretsin o parametrenin log-olasılığa etkisi neredeyse aynıdır.
Elle bir hesap bu tanımı somutlaştırır. Modelin bir sonraki token için üç adayı olsun: çay 0,6, kahve 0,3, su 0,1. Dört farklı parametre düşünün; her biri logitleri farklı biçimde oynatsın. Bölüm 4.2'de göreceğimiz gibi, tek bir token konumunda Fisher, parametrenin logitlere etkisinin modelin kendi olasılıkları altındaki varyansıdır.
| Parametre artınca logitlere etkisi (çay, kahve, su) | Fisher | Yorum |
|---|---|---|
| Üçünü birlikte artırır (+1, +1, +1) | 0 | Farklar değişmez, olasılıklar aynı kalır |
| Çay ve kahveyi birlikte artırır (+1, +1, 0) | 0,09 | Yalnızca olasılığı düşük olan suyu geriletir |
| Yalnız kahveyi artırır (0, +1, 0) | 0,21 | İkinci adayı öne çeker |
| Çayı artırır, kahveyi azaltır (+1, -1, 0) | 0,81 | İki güçlü aday arasındaki tercihi değiştirir |
Dört parametre de logitleri aynı büyüklükte oynatıyor, ama Fisher değerleri sıfırdan 0,81'e uzanıyor. Belirleyici olan parametrenin ne kadar güçlü olduğu değil, modelin ciddiye aldığı adaylar arasında ayrım yapıp yapmadığıdır. Makale A'ya göre gerçek bir modelde parametrelerin çoğu ilk iki satır gibi davranır; yazının konusu olan seyreklik buradan gelir.
Fisher continual learning literatüründe tanıdık bir araçtır: Elastic Weight Consolidation (Kirkpatrick ve arkadaşları, 2017) Fisher'ı yüksek olan ağırlıkları "eski görev için önemli" sayar ve onların değişmesini cezalandırır. Bu yazıdaki kullanım bunun tersidir: Fisher'ı yüksek olan ağırlıklar, yeni görevin de dokunacağı ağırlıklardır. Bu gerilime Bölüm 10'da döneceğiz.
3. Kökler: pruning literatürü fine-tuning'e geri dönüyor
Bu yazıdaki üç makalenin kullandığı araçların hiçbiri yeni değil. Yeni olan, otuz yıllık pruning (budama) araçlarının başka bir soruya çevrilmesi: "hangi ağırlığı atabilirim" yerine "hangi ağırlığa dokunmam yeter". Bu soy ağacını görmek, bugünkü sonuçların hangisinin gerçekten şaşırtıcı olduğunu ayırt etmeyi kolaylaştırır.
3.1 Önem skoru: 1989'dan Wanda'ya
İlk soru hep aynıydı: bir ağırlığın önemini eğitmeden nasıl ölçerim?
Optimal Brain Damage (LeCun, Denker ve Solla, 1989) kaybı ağırlık etrafında ikinci dereceden açar ve Hessian'ın yalnızca köşegenini tutar. Bir ağırlığı silmenin kayba etkisi, o ağırlığın karesi ile köşegen Hessian teriminin çarpımıyla tahmin edilir. Log-olabilirlik kayıplarında Hessian'ın beklentisi Fisher'a eşit olduğu için, bu skor fiilen diyagonal Fisher ile ağırlığın karesinin çarpımıdır. Bölüm 4'teki makalenin merkezindeki nesne 37 yıl önce aynı amaçla masadaydı.
Optimal Brain Surgeon (Hassibi ve Stork, 1993) köşegen varsayımını bırakıp tam Hessian'ın tersini kullanır ve bir ağırlığı sildikten sonra kalanları düzeltir.
Magnitude pruning (Han ve arkadaşları, 2015) tüm bunları atar ve yalnızca mutlak değeri küçük ağırlıkları siler. Şaşırtıcı derecede iyi çalışır ve yıllarca varsayılan yöntem olur.
SNIP (Lee ve arkadaşları, 2018) skoru eğitimin başına taşır: tek bir backward pass ile her bağlantının kayba duyarlılığı ölçülür ve seyrek ağ oradan eğitilir. Bölüm 5'teki "başlangıçta 50 backward pass ile giriş seç" prosedürü bunun doğrudan torunudur.
Wanda (Sun ve arkadaşları, 2023) LLM çağının pruning skoru: ağırlığın mutlak değeri ile ona gelen girdi aktivasyonunun normunun çarpımı. Gradyan gerektirmez, birkaç kalibrasyon örneği yeter. Deletion Tuning maskesini bu skorla başlatır.
3.2 Maske öğrenmek: ağırlığı değil seçimi eğitmek
İkinci soy çizgisi daha radikal bir fikirden gelir: ağırlıkları hiç eğitmeyip sadece hangilerinin kalacağını öğrenmek.
Lottery Ticket Hypothesis (Frankle ve Carbin, 2018) rastgele başlatılmış yoğun bir ağın içinde, tek başına eğitildiğinde tam ağın doğruluğuna ulaşan seyrek bir alt ağ bulunduğunu öne sürdü. Bugünkü "RL küçük bir alt ağı eğitiyor" bulgusu, aynı cümlenin önceden eğitilmiş modeller için söylenmiş halidir.
Supermask (Zhou ve arkadaşları, 2019) bir adım daha attı: rastgele ağırlıklara hiç dokunmadan sadece bir maske öğrenerek şansın çok üzerinde doğruluk elde edilebildiğini gösterdi. Ramanujan ve arkadaşları aynı yıl bunu ImageNet ölçeğine taşıdı. Bu çalışmaların mesajı şuydu: silmek de bir öğrenme biçimidir.
Piggyback (Mallya ve arkadaşları, 2018) Deletion Tuning'e en yakın atadır. Önceden eğitilmiş bir görü ağı dondurulur, her yeni görev için ağırlıkların üzerinde ikili bir maske öğrenilir. Tek bir omurga, görev başına bir bit. Amaç da aynıydı: unutmadan çoklu görev.
Dil modellerinde maskeleme (Zhao ve arkadaşları, 2020) aynı fikri BERT sınıfı modellere uyguladı ve fine-tuning ile karşılaştırılabilir sonuç aldı, ancak ağırlıkların kayda değer bir oranını maskeleyerek.
3.3 Seyrek fine-tuning: azını eğitmek
Üçüncü çizgi ağırlıkları eğitir ama yalnızca küçük bir kısmını.
Diff pruning (Guo ve arkadaşları, 2020) görev deltasını doğrudan seyrek olmaya zorlar; görev başına parametrelerin binde beşi kadarını saklayarak fine-tuning'e yaklaşır.
FISH Mask (Sung ve arkadaşları, 2021) Fisher'ı en yüksek parametreleri eğitimden önce seçer, maskeyi sabitler ve yalnızca onları eğitir. Bölüm 4'teki deneyin prosedürü budur. Fark, 2021'de bunun neden çalıştığına dair bir teorinin olmamasıydı.
Movement pruning (Sanh ve arkadaşları, 2020) fine-tuning sırasında büyüklüğe değil hareketin yönüne bakar: sıfıra doğru giden ağırlıklar prune edilir. Gradyanın işaretinin adımlar boyunca tutarlı olmasını ölçen ilk yaygın skorlardan biridir ve Bölüm 5'teki işaret tutarlılığı fikrinin habercisidir.
3.4 Soy ağacı
| 2026 çalışması | Kullandığı araç | En yakın ata | Yeni olan |
|---|---|---|---|
| Fisher merceği | Diyagonal Fisher, sabit maske | OBD (1989), FISH Mask (2021) | Fisher'ın gradyanı neden sınırladığının ispatı ve rejimler arası tek açıklama |
| LoRA yerleşimi | Başlangıçta gradyan skoru | SNIP (2018), movement pruning (2020) | Yerleşimin SFT'de önemsiz, RL'de belirleyici olduğunun gösterilmesi |
| Deletion Tuning | Öğrenilen ikili maske, Wanda başlangıcı | Piggyback (2018), supermask (2019) | Maskelenen oranın %0,05'in altına inmesi ve bunun RL'de FFT'ye yetmesi |
| Weight-Space Programming | LLM'in ağırlık okuyup yazması | Elle circuit analizi, derleyici tabanlı ağırlık üretimi (Tracr) | İşi insan ya da derleyici yerine genel amaçlı bir modelin yapması |
Bu tablodan çıkan sonuç şu: araçlar eski, ama üç şey gerçekten yeni. Birincisi ölçek: Piggyback görev başına ağırlık sayısı kadar bit saklıyordu, Deletion Tuning maskeyi ağırlık başına 0,03 bite sıkıştırıyor. İkincisi rejim ayrımı: eski çalışmaların hepsi SFT dünyasındaydı, seyrekliğin asıl güçlü olduğu yerin on-policy eğitim olduğu bilinmiyordu. Üçüncüsü açıklama: neden bazı ağırlıklara gradyan gelmediğine dair ilk kapalı form argüman.
4. Neden seyrek: Fisher merceği
Zhang, Mukherjee ve Peng seyrekliği tek bir eşitsizlikle açıklıyor: bir parametrenin beklenen gradyanı, o parametrenin diyagonal Fisher'ının kareköküyle sınırlıdır. Fisher'ı küçük olan parametre, eğitim sinyali ne olursa olsun, kayda değer bir gradyan alamaz.
4.1 Argümanın iskeleti
Makalenin kilit gözlemi, üç rejimin beklenen gradyanının aynı kalıba dökülebilmesidir. Model kendi dağılımından y örnekler, h_i o örneğin i numaralı parametreye göre skorudur, a(x,y) ise rejime özgü bir etkin sinyaldir:
Bu kalıba bir kez ulaşılınca gerisi tek satırlık Cauchy-Schwarz eşitsizliğidir:
Sağ taraf iki çarpana ayrılır ve bu ayrım makalenin bütün içeriğidir. İkinci çarpan yalnızca modele ve parametreye bağlıdır; görevden, ödülden, öğretmenden habersizdir. Birinci çarpan yalnızca eğitim sinyaline bağlıdır ve bütün parametreler için aynıdır. Dolayısıyla hangi parametrenin gradyan alacağı sorusunun cevabı, eğitim başlamadan modelin kendisinde yazılıdır.
Etkin sinyalin her rejimdeki karşılığı şöyle:
| Rejim | Etkin sinyal a | Sinyalin ölçeği | Ne zaman küçük |
|---|---|---|---|
| On-policy RL | Ödül eksi soru başına ortalama ödül | Ödülün koşullu varyansı | Her zaman sınırlı (ikili ödülde en fazla 0,25) |
| OPD, policy gradient biçimi | Öğretmen skorunun ortalamadan sapması | Öğretmen skorunun koşullu varyansı | Öğrenci öğretmene yakınken |
| OPD, tam sözlük biçimi | Öğretmen ve öğrenci olasılık oranlarının toplam sapması | Oran sapmalarının ikinci momenti | Öğrenci öğretmene yakınken |
| SFT | Veri olasılığının model olasılığına oranı eksi bir | Veri ile model arasındaki ki-kare uzaklığı | Veri modelin dağılımına yakınken |
SFT satırını açmak faydalı, çünkü argümanın en az sezgisel kısmı burası. SFT gradyanı veri dağılımı üzerinden bir beklentidir. Bunu modelin dağılımı üzerinden bir beklentiye çevirmek için önem örneklemesi oranı w = veri olasılığı / model olasılığı ile çarparsınız. Skorun beklentisi sıfır olduğu için w yerine w - 1 yazmak hiçbir şeyi değiştirmez. Ve (w - 1)'in ikinci momenti, tanım gereği veri ile model arasındaki ki-kare ıraksaklığıdır. Sonuç: veri modelin üreteceği şeye ne kadar benziyorsa sınır o kadar sıkıdır. Veri modele yabancılaştıkça ki-kare büyür, sınır gevşer ve Fisher'ı küçük parametreler de gradyan almaya başlayabilir.
Bu, önceki ampirik gözlemi tek cümleyle açıklıyor: RL ve OPD her zaman on-policy olduğu için her zaman seyrektir; SFT ancak verisi near-policy ise seyrektir. Makale off-policy SFT için sınırın "başarısız olduğunu" söylemiyor, yalnızca gevşediğini söylüyor; bu ayırım önemli.
4.2 Fisher neden küçük: token düzeyi açıklama
Eşitsizlik "Fisher küçükse gradyan küçük" der, ama Fisher'ın neden çoğu parametrede küçük olduğunu söylemez. Makalenin ikinci katkısı bu.
Tek bir token konumu için softmax'in türevini açarsanız, bir parametrenin skorunun şu olduğunu görürsünüz: örneklenen tokenin logitinin o parametreye duyarlılığı, eksi bütün tokenlerin duyarlılıklarının olasılık ağırlıklı ortalaması. Bunun karesinin beklentisi, yani token düzeyindeki Fisher, bir varyanstır:
Yani Fisher, logit duyarlılıklarının modelin kendi olasılıkları altındaki varyansıdır. Bu varyans iki durumda küçük olur: ya parametre hiçbir logiti etkilemiyordur, ya da olası tokenlerin hepsini benzer miktarda etkiliyordur. İkinci durum daha ilginç. Model bir sonraki token için "çay" ile "kahve" arasında kararlıysa ve bir parametre ikisinin logitini birlikte yukarı itiyorsa, o parametreyi oynatmak aralarındaki tercihi değiştirmez. Çıktı dağılımı aynı kalır, Fisher sıfıra yakındır. (Örnek makalenin kendi açıklayıcı örneğidir, ölçülmüş bir sonuç değildir.)
Bunu test etmek için yazarlar gerçek token Fisher'ını, aynı duyarlılıkların düzgün dağılım altındaki varyansıyla kıyaslıyor. Oran 1'in altındaysa, modelin olası bulduğu tokenler rastgele seçilmiş tokenlere göre birbirine daha benzer tepki veriyor demektir. Oran başlangıçta 0,16; 1000 adım RL sonra 0,04. En düşük Fisher'lı parametre gruplarında 0,03 ile 0,11 arasında.
Bu sonucun iki yorumu var. Birincisi, seyreklik ön eğitimin bir ürünüdür: model keskin ve tutarlı tahminler yapmayı öğrendikçe parametrelerin çoğu "tercih değiştirmeyen" yönlere yerleşir. İkincisi, RL bunu güçlendirir: oranın 0,16'dan 0,04'e düşmesi, eğitim ilerledikçe modelin daha da kararlı hale geldiğini ve seyrekliğin kendi kendini beslediğini gösterir.
4.3 Deneyler
Kurulum. RL deneyi Qwen3-1.7B-Base üzerinde, Dr. GRPO ile, SimpleRL-Zoo matematik verisinde yapılıyor; değerlendirme MATH-500. 1000 güncelleme, learning rate 5e-7, güncelleme başına 4 soru ve soru başına 8 cevap, dört seed. Başlangıç Fisher'ı 800 soru ve soru başına tek model cevabıyla tahmin ediliyor.
Fisher gradyanı nerede bulacağını biliyor mu? Eğitimden önce, Fisher'ı en yüksek %1'lik koordinat kümesi, gradyanı en büyük %1'lik kümenin %47,40'ını içeriyor. Rastgele seçimde bu %1 olurdu. OPD'de aynı ölçüm başlangıçta %35,66, 20 adım sonra %47,86.
Sabit Fisher maskesiyle eğitim. Asıl test bu: eğitimden önce Fisher'ı en yüksek %q parametreyi seç, gerisini dondur, sadece onları eğit.
| Eğitilen oran | Fisher maskesi | Rastgele maske | Tam eğitim kazancının geri kazanımı |
|---|---|---|---|
| %0,05 | 49,65 | 23,21 | %79,98 |
| %0,1 | 51,41 | 23,90 | %85,21 |
| %0,5 | 54,00 | 26,42 | %92,87 |
| %1 | 55,03 | 31,07 | %95,90 |
| %5 | 56,01 | 47,59 | %98,82 |
MATH-500 doğruluğu. Başlangıç 22,65, tam eğitim 56,41.
Tablonun en çarpıcı sütunu rastgele maske. %0,05 rastgele parametre eğitmek modeli 22,65'ten 23,21'e çıkarıyor, yani hiçbir şey yapmıyor. Aynı sayıda Fisher seçilmiş parametre 49,65'e çıkarıyor. Seyreklik "herhangi bir küçük alt küme yeter" demek değil; belirli bir alt küme yetiyor.
OPD tarafında sonuçlar aynı yönde ama gürültülü: değerlendirme 30 soruluk AIME24 üzerinde ve %0,5 ile %1'lik Fisher maskeleri pass@8'de tam eğitimi geçiyor (52,50 ve 55,00'a karşı 47,50). Otuz soruda bu fark iki üç soruya denk gelir; "maske tam eğitimden iyi" diye okumak doğru olmaz.
4.4 Eleştirel okuma
Makale dikkatli yazılmış ve iddiasını dar tutuyor. Yine de altı nokta aklın bir köşesinde durmalı.
Sınır tek yönlü. Küçük Fisher küçük gradyanı garanti eder; büyük Fisher büyük gradyanı garanti etmez. %47'lik örtüşme bunu gösteriyor: Fisher'ı yüksek parametrelerin yarısından fazlası en büyük gradyanlılar arasında değil. Fisher bir eleme ölçütüdür, bir seçme ölçütü değil.
Beklenen gradyan, gerçek güncelleme değildir. Sınır sabit bir policy'de tek adımın beklenen gradyanı için geçerli. Yazarlar optimizer dinamiğini, gradyan gürültüsünü ve learning rate schedule'ını modellemediklerini açıkça söylüyor. Bizim okumamıza göre buradaki en büyük boşluk Adam. Adam her parametrenin gradyanını kendi geçmiş büyüklüğüne böler; küçük ama tutarlı bir gradyan, büyük ama gürültülü bir gradyan kadar büyük adım attırabilir. Adam altında belirleyici olan gradyanın büyüklüğü değil, ortalamasının gürültüsüne oranıdır. Bu tam olarak Bölüm 5'teki makalenin ölçtüğü şeydir ve iki makaleyi birbirine bağlayan eksik halka burasıdır.
Tek model, tek boyut. Bütün deneyler Qwen3-1.7B ailesinde. Bulgu başka ailelerde ve ölçeklerde tekrarlanmadı.
Magnitude baseline'ı yok. Fisher maskesi yalnızca rastgele maskeyle kıyaslanıyor. Ağırlık büyüklüğü, Wanda skoru ya da doğrudan gradyan büyüklüğüyle seçilen maskelerin ne yapacağı bilinmiyor. Bölüm 5'teki makale gradyan ortalaması ile Fisher'ı kıyaslıyor ve ikisini birbirine çok yakın buluyor; bu, Fisher'ın özel bir yanı olmayabileceğine işaret eder. Eksik karşılaştırmayı Bölüm 8.3'te küçük ölçekte yaptık.
Yüksek Fisher'lı parametreler nerede? Makale katman ya da modül bazında bir döküm vermiyor. "Hangi ağırlıklar" sorusunun anatomik cevabı bu makalede yok; Bölüm 5 o boşluğu dolduruyor.
Hesap tasarrufu gösterilmedi. Maskeli eğitim yoğun hesapla yapılıyor: bütün gradyanlar hesaplanıp maske dışındakiler atılıyor. Yazarlar da Fisher seçimini bir yöntem olarak değil, açıklamalarının bir testi olarak sunuyor.
5. Hangi parametreler: LoRA'da yerleşim problemi
Sehanobish ve Lovering soruyu en yalın haline indiriyor: eğitilebilir parametre bütçeniz k ise, hangi k parametreyi seçtiğiniz fark eder mi? Cevap, RL altında "her şeyi belirler", SFT altında "neredeyse hiç" çıkıyor ve farkın sebebi gradyanın geometrisinde yatıyor.
5.1 Deney düzeneği
Kurulum bilinçli olarak kısıtlı. Standart LoRA bloğun bütün doğrusal katmanlarına takılıyor. A matrisi rastgele başlatılıp donduruluyor, B sıfırdan başlıyor ve B'nin yalnızca k girişi eğitiliyor. Qwen2.5-1.5B için B matrislerinin toplamı yaklaşık 20,6 milyon giriş; bütçe 1.000 ile 500.000 arasında değişiyor, ana sonuçlar 5.000 ile 100.000 arasında. Yani konuştuğumuz oran B'nin on binde biri ile yüzde yarımı arası.
Neden yalnızca B? Makale aynı bütçeyi A ve B'ye dağıtmayı da deniyor ve B'nin her bütçede kazandığını gösteriyor: Qwen2.5-1.5B'de 1.600 parametreyle GSM8K doğruluğu yalnızca B eğitilince %61,2, A ve B birlikte eğitilince %9,3. Bunun basit bir cebirsel sebebi var (bizim notumuz): B sıfırken kaybın A'ya göre türevi de sıfırdır, çünkü A'nın çıktısı B ile çarpılıp yok olur. Başlangıçta A girişlerine skor verilemez ve A'ya ayrılan bütçe, B yeterince büyüyene kadar ölü kalır.
5.2 Skorlama prosedürü
Seçim eğitimden önce, tek seferde yapılıyor. Başlangıç noktasında N adet forward-backward pass çalıştırılıyor ve her B girişi için iki skordan biri hesaplanıyor:
Sonra bütün modül ve katmanlar üzerinden global olarak en yüksek k giriş seçiliyor. Varsayılan N = 50; N = 10 ile 100 pass'lik referans circuit'in (makale seçilen giriş kümesine circuit diyor) %90'ından fazlası, N = 50 ile yaklaşık %98'i geri geliyor. Tek GPU'da 10 saniyeden kısa sürüyor ve eğitim FLOP'larının SFT'de %0,49'u, GRPO'da %0,18'i kadar.
İki skor arasındaki ilişki öğretici. İkinci moment, ortalamanın karesi artı varyansa eşittir. Yani F̂ büyük gradyan alan girişleri bulur, işaretin tutarlı olup olmadığına bakmaz. Ŝ ise yalnızca gradyanı örnekler boyunca aynı yöne bakan girişleri ödüllendirir; işareti sürekli değişen bir girişin ortalaması sıfıra gider. Makalede ayrı bir işaret tutarlılığı eşiği yok, bu işi mutlak ortalama kendiliğinden yapıyor. İki skorun pratikte birbirine çok yakın sonuç vermesi, RL altında "büyük gradyan alan" ile "tutarlı gradyan alan" girişlerin büyük ölçüde aynı küme olduğunu düşündürüyor.
Bir terminoloji uyarısı: buradaki F̂, Bölüm 4'teki Fisher ile aynı aileden ama aynı nesne değil. Bölüm 4'te örnekler modelin kendi dağılımından çekiliyor ve etiket kullanılmıyor. Burada ise ek, circuit keşfinin cross-entropy kaybıyla yapıldığını söylüyor; yani skor görev verisine bakıyor. İlki modele, ikincisi model ile görevin birleşimine ait bir ölçüm.
5.3 Ana sonuç: rejim her şeyi değiştiriyor
GRPO altında rastgele yerleşim öğrenmiyor. MATH veri kümesinde GRPO ile eğitim, GSM8K ve MATH-500'de değerlendirme:
| Model, değerlendirme | Baz | Rastgele | Ŝ | F̂ | Tam LoRA |
|---|---|---|---|---|---|
| Qwen2.5-1.5B, GSM8K | 9,5 | 9,8 | 64,2 | 63,2 | 62,8 |
| Qwen2.5-3B, GSM8K | 62,1 | 62,3 | 70,6 | 73,6 | 71,9 |
| Qwen2.5-7B, GSM8K | 79,3 | 79,6 | 85,2 | 86,3 | 87,6 |
| Qwen2.5-1.5B, MATH-500 | 17,4 | 18,8 | 43,6 | 42,2 | 41,4 |
| Qwen2.5-3B, MATH-500 | 50,6 | 51,0 | 60,4 | 63,2 | 62,6 |
| Qwen2.5-7B, MATH-500 | 53,6 | 55,2 | 74,8 | 76,0 | 74,6 |
| Llama-3.2-3B-Inst, GSM8K | 70,4 | 67,9 | 73,9 | 72,6 | 74,7 |
| Llama-3.1-8B-Inst, GSM8K | 82,9 | 83,4 | 86,2 | 85,9 | 86,4 |
| Llama-3.2-3B-Inst, MATH-500 | 43,6 | 50,2 | 50,8 | 51,0 | 50,8 |
| Llama-3.1-8B-Inst, MATH-500 | 50,4 | 53,2 | 54,6 | 55,8 | 56,6 |
Doğruluk (%). Bütçe 10.000 ya da 50.000 giriş.
Base modellerde tablo keskin: rastgele sütun baz sütununun kopyası, bilinçli yerleşim ise tam LoRA ile başa baş, birkaç satırda üstünde. Rastgele yerleşimin başarısızlığı bir hiperparametre kazası da değil: ek, LoRA alpha'yı 32'den 4.096'ya, bütçeyi 1.000'den 10.000'e taradığında Qwen2.5-1.5B'nin GSM8K'da %9,3 ile %9,8 aralığından çıkamadığını gösteriyor.
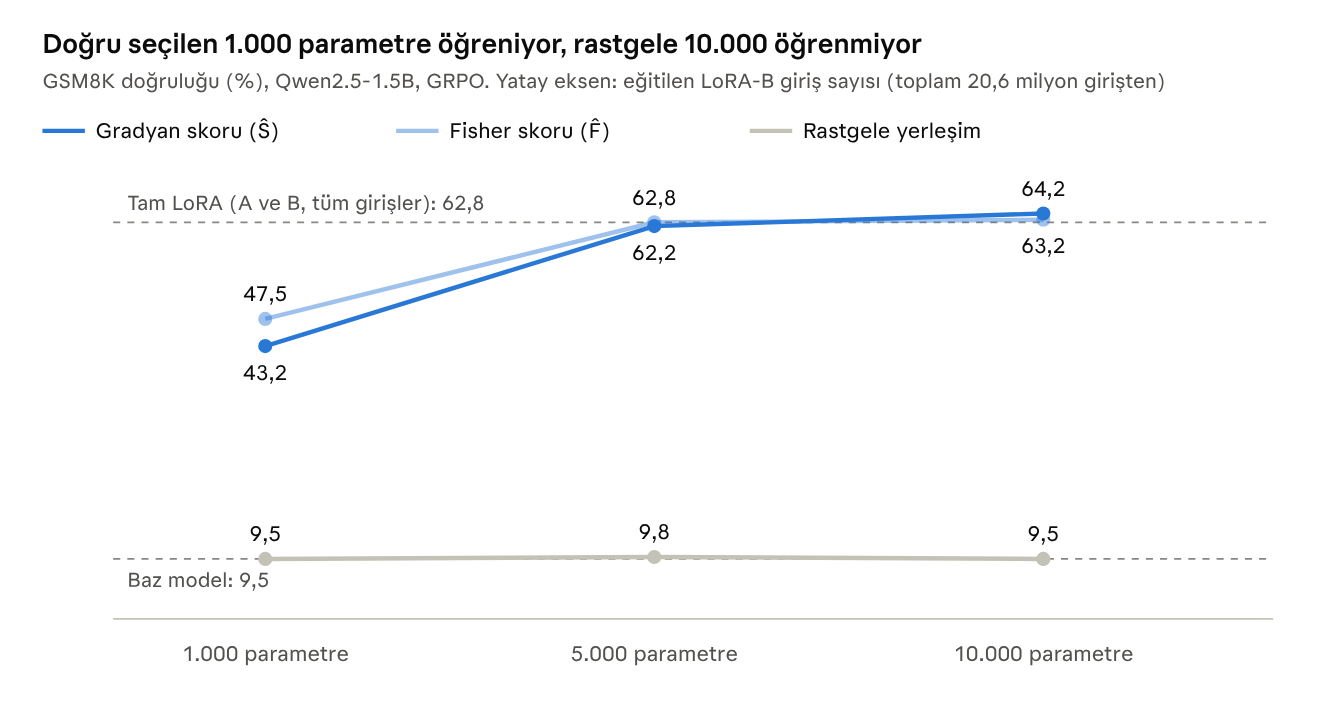
Bilinçli yerleşim 5.000 girişte tam LoRA'ya yetişiyor; rastgele yerleşim eğrisi baz model çizgisinden hiç ayrılmıyor.
Instruct modellerde ise fark eriyor. Llama-3.2-3B-Instruct'ın MATH-500 satırında rastgele 50,2, bilinçli 50,8 ve 51,0. Buna Bölüm 5.6'da döneceğiz, çünkü makalenin başlığındaki iddianın kapsamını belirliyor.
SFT altında yerleşim önemsiz. Alpaca üzerinde SFT, yedi benchmark'ın ortalaması:
| Model | Baz | Rastgele | Ŝ | F̂ | Tam LoRA |
|---|---|---|---|---|---|
| Qwen2.5-1.5B | 53,0 | 61,6 | 61,9 | 62,1 | 62,4 |
| Qwen2.5-3B | 65,6 | 65,8 | 66,2 | 66,0 | 66,7 |
| Qwen2.5-7B | 70,9 | 71,1 | 71,4 | 71,5 | 71,5 |
| Llama-3.2-3B-Inst | 62,3 | 62,9 | 63,8 | 63,7 | 63,9 |
| Llama-3.1-8B-Inst | 68,7 | 69,1 | 69,6 | 69,7 | 69,9 |
Rastgele ile bilinçli arasındaki fark her satırda bir puanın altında. Ancak bu tablo iki şeyi gizliyor. Birincisi, beş satırın dördünde tam LoRA'nın kendisi baz modeli yalnızca bir iki puan geçiyor; öğrenilecek pek bir şey olmayan bir görevde yerleşimin önemsiz çıkması şaşırtıcı değil. İkincisi, daha zor bir SFT görevinde tablo değişiyor: Bespoke-Stratos verisinde eğitilip GPQA Diamond'da ölçülen Qwen2.5-7B-Instruct'ta 5.000 girişle rastgele 41,1, Ŝ 43,3, tam LoRA 50,7. Burada seyrek B'nin tamamı tam LoRA'nın belirgin gerisinde ve F̂ skoru 31,1 ile baz seviyesinde (31,6) kalıyor. Makale bu son sonucu açıklamıyor.
5.4 Mekanizma: gradyanın geometrisi
Makalenin asıl katkısı sonuç tablosu değil, sonucun açıklaması. Üç ölçüm iki rejimi ayırıyor:
| Model | Efektif rank (SFT / GRPO) | Adımlar arası kosinüs (SFT / GRPO) | Birikim verimi (SFT / GRPO) |
|---|---|---|---|
| Qwen2.5-1.5B | 2,6 / 21,8 | 0,76 / 0,04 | 0,90 / 0,28 |
| Qwen2.5-3B | 5,8 / 7,7 | 0,61 / -0,03 | 0,81 / 0,22 |
| Qwen2.5-7B | 2,0 / 8,8 | 0,85 / -0,03 | 0,93 / 0,18 |
Üç sütun aynı hikâyeyi üç açıdan anlatıyor.
Efektif rank tek bir adımın gradyanının kaç bağımsız yönden oluştuğunu söyler. SFT'de gradyan iki üç yönün birleşimi; GRPO'da sekiz ile yirmi iki arası.
Adımlar arası kosinüs ardışık adımların gradyanlarının aynı yöne bakıp bakmadığını söyler. SFT'de 0,6 ile 0,85 arası: her adım bir öncekini tekrar ediyor. GRPO'da sıfır: her adım bir öncekine dik.
Birikim verimi adımların vektör toplamının uzunluğunun, adım uzunluklarının toplamına oranıdır. SFT'de atılan her on birimlik yolun dokuzu ilerlemeye dönüşüyor. GRPO'da beşte dördü kendini götürüyor.
Buradan yerleşim sonucuna giden mantık şöyle. Rastgele k giriş seçmek, gradyanı rastgele bir k boyutlu alt uzaya izdüşürmek demektir. SFT'de gradyan adımdan adıma aynı kaldığı için izdüşümü de aynı kalır; küçük de olsa her adımda aynı yöne itilirsiniz ve birikirsiniz. GRPO'da gradyanın büyük kısmı gürültüdür ve adımlar arasında sönümlenir. Kalıcı sinyal, işareti tutarlı olan çok az sayıda girişte yaşar. Rastgele bir alt küme bu girişleri neredeyse hiç içermez ve geriye saf gürültü kalır.
Bunu bir yürüyüş olarak düşünün. Her biri bir birim uzunluğunda 2.000 adım atıyorsunuz; Makale B'deki GRPO eğitimi de 2.000 adım sürüyor. Adımların hepsi aynı yöne bakıyorsa 2.000 birim ilerlersiniz. Her adım rastgele bir yöne bakıyorsa beklenen ilerleme adım sayısının karekökü kadardır: yaklaşık 45 birim. Aynı emek, kırk dört kat az yol. SFT birinci yürüyüşe, GRPO ikincisine yakındır. GRPO'da ilerlemeyi sağlayan, bütün o gürültünün içinde her adımda aynı yöne bakan küçük bileşendir ve o bileşen az sayıda koordinatta yaşar.
İki sayı bu resmi pekiştiriyor. B girişlerinin en yüksek skorlu %0,05'i gradyan enerjisinin %8 ile %15'ini taşıyor, yani rastgele beklentinin 160 ile 300 katını. Ve eğitim boyunca seçilen girişler GRPO'da rastgele girişlerin 1,4 ile 2,1 katı kadar yer değiştiriyor. SFT'de ise tersine, seçilen girişler rastgele girişlerden daha az hareket ediyor (0,24 ile 0,41 kat). Bu son gözlem ilginç: SFT'de başlangıç gradyanı büyük olan girişler hızla doyuyor ve işin geri kalanı başka yerde yapılıyor demektir. SFT'de başlangıç skoru, nihai güncellemenin iyi bir habercisi değil.
Bölüm 4 ile bağlantı burada kuruluyor. Fisher sınırı beklenen gradyanın nerede sıfır olacağını söylüyordu. Bu makale ise beklenenin etrafındaki gürültüyü ölçüyor ve RL'de gürültünün sinyali neredeyse her yerde boğduğunu gösteriyor. İkisi birlikte tam resmi verir: on-policy eğitimde sinyal az sayıda koordinatta yaşar (Fisher), ve o koordinatların dışında kalan her şey adımlar arasında kendini götürür (kosinüs).
5.5 Circuit'in anatomisi
Seçilen girişler bloğun neresinde? Parametre sayısı bakımından gate ve up baskın olduğu halde seçim oraya düşmüyor.
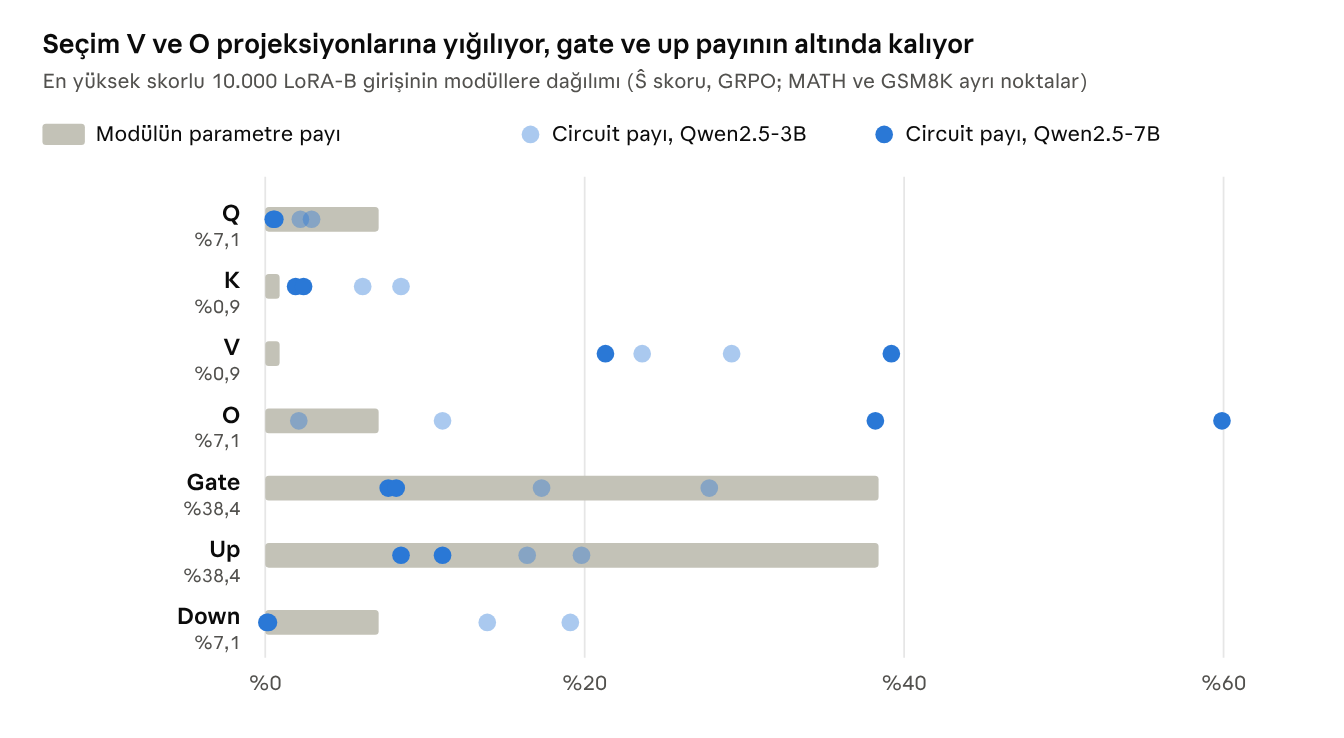
Gri çubuk bir modülün rastgele seçimde alacağı payı, noktalar gerçekte aldığı payı gösteriyor. Çubuğun sağındaki nokta aşırı temsil, solundaki nokta eksik temsil demek.
Üç düzenlilik öne çıkıyor.
V her ayarda aşırı temsil ediliyor. Parametrelerin %0,9'unu tutan V, circuit'in %21 ile %39'unu alıyor: payının 23 ile 43 katı.
O büyük modelde baskın. 3B'de O'nun payı %2 ile %11 arasındayken 7B'de %38 ile %60'a çıkıyor. Buna karşılık down 3B'de %14 ile %19 alırken 7B'de neredeyse sıfıra düşüyor. Makalenin özeti "V, O ve down" diyor, ama tablo modelden modele değişen bir resim gösteriyor; sabit kalan tek şey V.
Gate ve up az seçiliyor. İkisi birlikte parametrelerin %77'sini tutuyor, circuit'in 3B'de %37 ile %44'ünü, 7B'de %16 ile %19'unu alıyor. Ek, bu modüllerin gradyan işaretinin V ve O kadar tutarlı olduğunu, yani tutarlılığın gerekli ama yeterli olmadığını not ediyor. Yazarların açıklaması, gate ve up'ın residual stream'e doğrudan değil MLP'nin iç hesabı üzerinden etki etmesi.
Derinlik ekseninde yoğunlaşma daha da keskin. Bütçenin ilk beş katmana (0-4) düşen payı Qwen-3B'de %71,7, Qwen-7B'de %98,9, Llama-3B'de %97,4, Llama-8B'de %96,8. Tek istisna Qwen-7B-Instruct: orada erken katmanların payı %18'e düşüyor ve bütçe orta ve geç katmanlara kayıyor.
Seçimin nedensel olduğunu gösteren bir de sökme deneyi var: tam eğitilmiş bir LoRA'da en yüksek skorlu girişler sıfırlanınca doğruluk, aynı sayıda rastgele giriş sıfırlanmasına göre çok daha hızlı düşüyor. Qwen-7B'nin MATH sonucunda LoRA'nın 21,6 puanlık kazancının 12,2 puanı bu yolla geri alınıyor.
5.6 Eleştirel okuma
İddia base modellere özgü. Ek açıkça söylüyor: instruct modellerde her iki rejim de dağınık gradyan üretiyor ve SFT ile GRPO arasındaki zıtlık kayboluyor. Pratikte RL ile eğitilen modellerin çoğu instruct modeller olduğu için bu, makalenin en önemli sınırı. Neden böyle olduğu açıklanmıyor. Bir hipotez: instruct fine-tuning zaten erken katmanlardaki "kolay" circuit'i kullanmış ve doyurmuştur; Qwen-7B-Instruct'ta bütçenin geç katmanlara kayması bununla uyumlu.
Erken katman yoğunlaşması bir ölçek yan etkisi olabilir. Seçim global: bütün katmanların girişleri aynı havuzda yarışıyor ve skor ham gradyan büyüklüğü. Erken katmanların gradyan normu sistematik olarak büyükse, global sıralama onları öne çıkarır. Makalede katman başına normalize edilmiş bir seçimle karşılaştırma göremedik. %98,9 gibi bir yoğunlaşma, işlevsel bir bulgu olabileceği kadar bir normalizasyon yan etkisi de olabilir. Bu, Bölüm 11'deki deney önerilerinden biri.
"Hangi giriş" sorusu rastgele bir tabana göre soruluyor. B girişlerinin anlamı dondurulmuş rastgele A'ya bağlı. A'yı hafifçe bozunca (ε = 0,1) seçilen ilk 10.000 girişin %92 ile %94'ü korunuyor, ama tamamen farklı bir A ile (ε = 1,0) örtüşme %42 ile %54'e düşüyor. Modül ve katman düzeyindeki dağılım ise sekiz farklı A seed'inde en fazla 3 puan oynuyor. Doğru okuma şu: kararlı olan tek tek girişler değil, girişlerin hangi modül ve katmana düştüğü.
Kapsam. Yalnızca matematik muhakemesi denenmiş; kod, diyalog ve açık uçlu görevler yok. En büyük model 8B. Yazarlar, O(k) maliyet avantajının gerçekleşmesi için özel sparse kernel'ler gerektiğini de belirtiyor; bugünkü uygulamada bütün gradyanlar yine hesaplanıyor.
İç tutarsızlıklar. Ana metindeki bazı rakamlar (SFT için "neredeyse rank-1", kosinüs 0,87; GRPO için "rank-24", kosinüs 0,08) yukarıdaki tabloyla birebir örtüşmüyor; LoRA rankı için de metin ile hiperparametre tablosu arasında fark var. Sonucun yönünü değiştirmiyor, ama alıntı yaparken tablo değerlerini esas almak daha güvenli. Bu değerlendirme metin çıkarımı üzerinden yapıldı; orijinal PDF'te teyit edilmeli.
6. Ne kadar az: Deletion Tuning
Lu ve arkadaşları (NeurIPS 2026) seyreklik sorusunu en uç noktasına götürüyor: hiçbir ağırlığa yeni bir değer verilmiyor, yalnızca bazıları sıfırlanıyor. 7B ve üstü modellerde, ağırlıkların %0,05'inden azını silmek GRPO altında tam fine-tuning ile aynı doğruluğu veriyor ve model önceki yeteneklerini neredeyse hiç kaybetmiyor.
6.1 Yöntemin mekaniği
Parametrizasyon. Yalnızca MLP'lerin gate projeksiyonu hedefleniyor. Her gate ağırlığının yanına bir logit G konuyor. Ağırlığın kendisi donuk; eğitilen tek şey G. Eğitim sırasında etkin ağırlık yumuşak bir maskeyle hesaplanıyor:
Keskinlik katsayısı α, GRPO için eğitim boyunca 1.000'den 10.000'e doğrusal olarak artıyor. Değerlendirmede ve RL örneklemesinde sert maske kullanılıyor: G pozitifse ağırlık kalır, değilse silinir. Makale yumuşak ve sert maskenin sonuçlarının en fazla 0,08 puan ayrıştığını söylüyor; bu kadar yüksek α değerlerinde sigmoid zaten bir basamak fonksiyonuna çok yakın. Straight-through estimator kullanılmıyor, gradyan yumuşak maskenin içinden akıyor.
Başlangıç. Logitler rastgele değil, Wanda skoruna göre başlatılıyor. Önem skoru yüksek ağırlıkların logiti +0,03 etrafında, düşük olanlarınki -0,03 etrafında çekiliyor (standart sapma 0,012). Bunun sonucunda eğitim, gate ağırlıklarının yaklaşık %0,18'i zaten silinmiş olarak başlıyor. Yani başlangıç noktası baz model değil, baz modelin çok hafif prune edilmiş hali.
Seyreklik hedefi yok. Kaç ağırlığın silineceği önceden belirlenmiyor; sayı eğitimden kendiliğinden çıkıyor. GRPO ve SFT'de maskelenmiş ağırlık normuna bağlı küçük bir düzenlileştirme terimi var (λ = 1e-5; yazarlara göre maskeyi büyük ağırlıkları korumaya doğru hafifçe itiyor), on-policy distillation'da yok.
Neden gate. SwiGLU'da gate, her ara nöronun down projeksiyonuna ne kadar sinyal göndereceğini çarpımsal olarak belirliyor. Bir gate ağırlığını silmek, residual stream'in belirli bir boyutunun belirli bir nöronun açılma kararına katkısını kaldırmak demek. Nöronun ne hesapladığı (up) ve nereye yazdığı (down) değişmiyor; yalnızca ne zaman devreye girdiği değişiyor. MoE modelde 128 uzmanın her birinin içindeki gate maskeleniyor, yönlendirici değişmiyor.
Saklama. Maske bit olarak paketlenip zstd ile sıkıştırılıyor ve maskelenen ağırlık başına yaklaşık 0,03 bit tutuyor. Silinenler o kadar seyrek ki maske neredeyse tamamen birlerden oluşuyor ve çok iyi sıkışıyor.
Burada bir kaba hesap yapmak faydalı (bizim hesabımız, makalede yok). Llama-3 8B'de 32 katmanın her birinde 4.096 x 14.336 boyutunda bir gate matrisi var; toplam yaklaşık 1,88 milyar ağırlık, modelin dörtte birine yakın. Bunun %0,18'i, bütün ağırlıkların kabaca %0,04'ü eder. Makalenin nihai rakamı ise her GRPO koşusunda %0,05'in altı. İki sayı aynı mertebede. Eğer bu hesap doğruysa, eğitim maskeyi büyütmekten çok yerini değiştiriyor: başlangıçta silinen "önemsiz" ağırlıkların bir kısmı geri geliyor, yerlerine göreve özgü olanlar siliniyor. Makalenin Tablo 7'si bu okumayı destekliyor: Llama-1B'de silinen oran ilk kayıtlı checkpoint'te %0,0342, eğitim sonunda %0,0347. Net sayı neredeyse sabit. Kaç maske girişinin yer değiştirdiği ise raporlanmamış; öğrenmenin takasla mı gerçekleştiğini, yoksa ilk checkpoint'ten önce mi tamamlandığını bu rakamlardan ayıramıyoruz.
6.2 Maske gerçekten öğreniliyor mu?
Başlangıç Wanda ile yapıldığına göre akla gelen ilk itiraz şu: belki işi yapan Wanda'dır, eğitim değil. Makale bunu doğrudan test ediyor. Yalnızca Wanda skoruyla seçilmiş en iyi maske baz modelin 2,4 puan yakınında kalıyor. Aynı başlangıçtan eğitilen maske 53,2 puana kadar kazanıyor. Pruning skoru bir başlangıç noktası sağlıyor, yeteneği kazandıran ise RL sinyaliyle öğrenilen seçim.
6.3 Sonuçlar
GRPO. Llama modelleri GSM8K'da eğitilip ölçülüyor (dağılım içi). Qwen modelleri SimpleRL-Zoo matematik verisinde eğitilip altı benchmark'ın ortalamasıyla ölçülüyor (dağılım dışı).
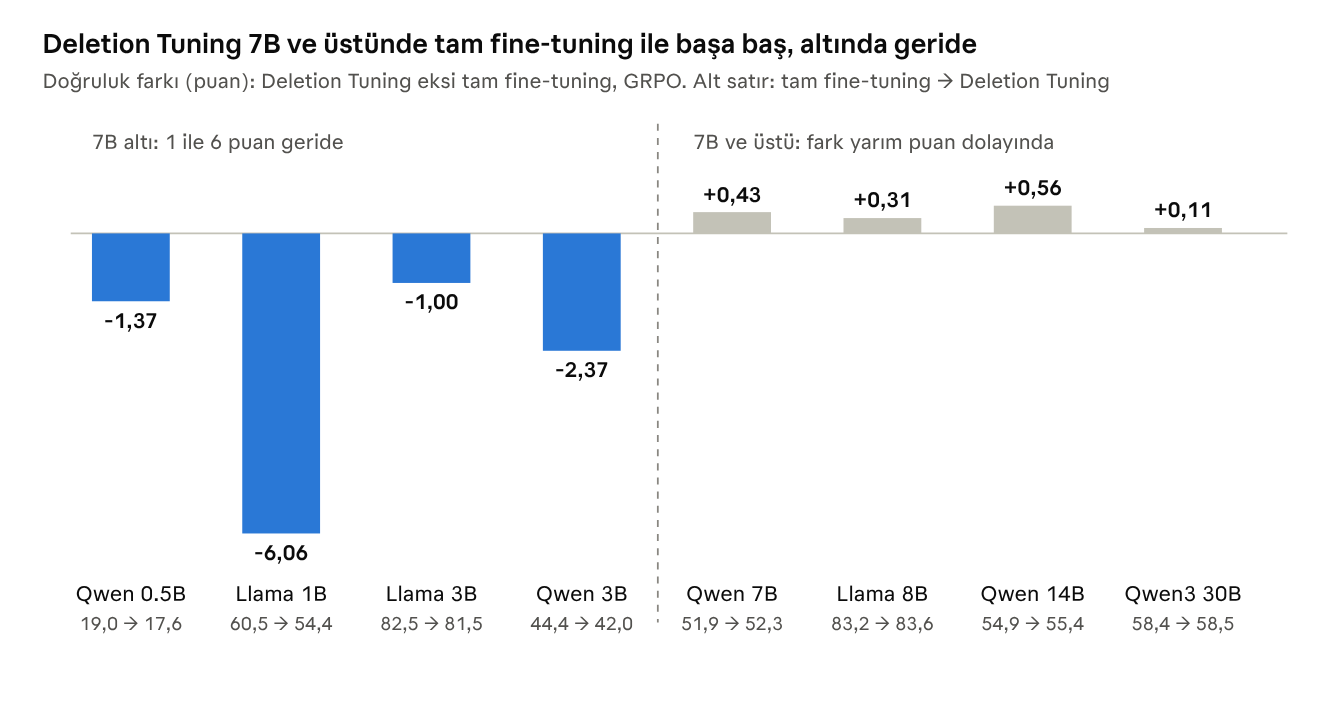
Grafiğin söylediği açık: ölçek büyüdükçe fark kapanıyor ve 7B'den itibaren işaret değiştiriyor. 0.5B ile 3B arasında Deletion Tuning 1 ile 6 puan geride; 7B, 8B, 14B ve 30B'de 0,1 ile 0,6 puan önde. Öndeki farklar gürültü düzeyinde, yani doğru okuma "eşit"tir; ama geride kalma küçük modellerde sistematik.
Aynı tablodaki diğer iki baseline da kayda değer. Rank-1 LoRA ve MTH (Multiple Ticket Hypothesis; bütün parametrelerin rastgele seçilmiş %0,05'ini eğiten bir baseline) Llama-8B'de 83,38 ve 83,07; Qwen-7B'de 52,13 ve 51,24 alıyor. Yani büyük modellerde dört yöntem de birbirinin yarım puan yakınında. Doğruluk açısından Deletion Tuning'i ayıran bir şey yok; farkı yaratan boyut ve unutma.
Boyut.
| Model | Tam fine-tuning checkpoint'i | Deletion Tuning maskesi | Oran |
|---|---|---|---|
| Llama 8B | 30.633 MB | 8,4 MB | yaklaşık 3.600 kat |
| Qwen 7B | 29.051 MB | 6,9 MB | yaklaşık 4.200 kat |
| Qwen 14B | 56.343 MB | 11,4 MB | yaklaşık 4.900 kat |
| Qwen3 30B (MoE) | 116.471 MB | 29,6 MB | yaklaşık 3.900 kat |
Pass@k: yetenek zaten oradaydı. Makalenin en az konuşulan ama bizce en öğretici tablosu bu. Llama-8B baz modeli GSM8K'da tek denemede %53,20 alıyor; 128 denemede en az birinin doğru olma oranı ise %95,29. Yani baz model soruların neredeyse tamamını çözebiliyor, yalnızca doğru cevabı her seferinde üretmiyor. Deletion Tuning'den sonra tek deneme %81,75'e, 128 deneme %99,62'ye çıkıyor. Değişen şey modelin ne yapabildiği değil, yapabildiğini ne sıklıkla yaptığı. Bu, yazının ana tezinin en doğrudan kanıtı: RL post-training olasılık kütlesini var olan doğru davranışın üzerine topluyor.
SFT ve on-policy distillation. Burada tablo daha karışık.
| Rejim, model, görev | Tam fine-tuning | Deletion Tuning |
|---|---|---|
| SFT, Llama 3B, MMLU-Pro (14 konu) | 21,19 | 22,28 |
| SFT, Llama 1B, BBEH (23 alt görev) | 8,35 | 5,65 |
| OPD, Qwen 7B, ToolAlpaca | 68,04 | 69,07 |
| OPD, Qwen 7B, Science | 71,20 | 70,61 |
Distillation maskelerinin boyutu dikkat çekici: 27,1 ve 47,1 MB. Aynı Qwen-7B'nin GRPO maskesi 6,9 MB idi. Distillation, RL'in dört ile yedi katı kadar silme gerektiriyor. Bu, Bölüm 4'ün öngörüsüyle uyumlu bir yan bulgu (bizim okumamız): eğitim sinyali modelin kendi dağılımından uzaklaştıkça dokunulması gereken ağırlık kümesi büyüyor.
6.4 Unutma
Makale unutmayı iki şekilde ölçüyor: eğitilmiş modelin çıktı dağılımının baz modelden ne kadar uzaklaştığı (ileri KL) ve altı önceki görevdeki doğruluk (HellaSwag, MMLU, TruthfulQA, WinoGrande, IFEval, HumanEval).
| Yöntem | İleri KL (eğitim sonu) | Önceki görev doğruluğu, baza göre |
|---|---|---|
| Tam fine-tuning | 1,0 (1B) ile 1,5 (8B) | 1,3 ile 3,1 puan düşük |
| LoRA r=1 ve MTH (rastgele seyrek) | 0,4 ile 1,3 | 5,4 puana kadar düşük |
| Deletion Tuning | 0,05 ve altı | bir puanın içinde |
KL farkı yirmi ile otuz kat. Bu, doğruluk tablosundaki yarım puanlık farklardan çok daha büyük bir ayrışma ve makalenin asıl satış noktası. İlginç olan, rank-1 LoRA'nın tam fine-tuning'den daha fazla unutması: az parametre eğitmek tek başına unutmayı azaltmıyor, değişikliğin biçimi de önemli.
Bir sınırı açıkça belirtmek gerek: bu, tek bir görev eğitildikten sonraki unutma ölçümü. Ardışık görevlerle gerçek bir continual learning deneyi yapılmamış; yazarlar bunu gelecek iş olarak bırakıyor.
6.5 Güncellemenin geometrisi
Makale, dört yöntemin ürettiği deltayı üç ölçüyle karşılaştırıyor. Bu ölçüler weight space analizinin standart araçları olduğu için tek tek açmaya değer.
Stable rank. Bir matrisin Frobenius normunun karesinin, spektral normunun karesine oranıdır:
Rank'ın gürültüye dayanıklı versiyonudur: enerjinin kaç tekil yöne yayıldığını söyler. Rank-1 LoRA'da tanım gereği 1 ile 2 arasında. Rastgele seyrek baseline MTH'de 410 ile 650. Deletion Tuning'de 66 ile 93. Yani silme maskesi düşük ranklı değil, ama rastgele seyrek bir güncelleme kadar dağınık da değil; aradaki yapılandırılmış bir bölgede duruyor.
Spektrum kayması. Eğitimden sonra ağırlık matrisinin tekil değerlerinin ne kadar değiştiğini ölçer. Deletion Tuning tam fine-tuning'in 1,4 katı içinde kalıyor. Rank-1 LoRA ise Llama-8B'de tam fine-tuning'in 84 katına kadar kayıyor. Tek bir yöne sıkıştırılmış bir güncelleme, o yöndeki tekil değeri orantısız şişiriyor. LoRA'nın daha çok unutmasının muhtemel açıklaması bu.
Ana ağırlık örtüşmesi. Güncellemenin, matrisin en büyük tekil yönlerine en çok katkı yapan ağırlıklarla ne kadar çakıştığını ölçer; rastgele beklenti 0,5. Deletion Tuning 0,43 ile 0,46, tam fine-tuning 0,41 ile 0,46 alıyor: ikisi de rastgelenin altında. LoRA 0,48 ile 0,50, MTH 0,50. Yazarlar rastgelenin altındaki örtüşmeyi ve düşük spektrum kaymasını, Zhu ve arkadaşlarının "The Path Not Taken: RLVR Learns Off the Principals" (NeurIPS 2026) çalışmasına dayanarak RL'in imzası olarak okuyor: RL, modelin ana yönlerinden kaçınıyor ve ikincil ağırlıklarda çalışıyor.
Üç ölçünün ortak sonucu: dört yöntem arasında tam fine-tuning'e geometrik olarak en çok benzeyen Deletion Tuning. Ölçümler iki kayıtlı checkpoint üzerinde yapılmış (Llama-8B adım 348, Qwen-7B adım 100).
6.6 Silmek neden yetiyor?
Makale bu soruya teorik bir cevap vermiyor. Üç açıklama adayı var; üçü de bizim okumamız.
Kombinatoryal zenginlik. Bir silme güncellemesinin her girişi ya sıfır ya da mevcut ağırlığın eksilisi; büyüklük seçilemiyor. Bu çok kısıtlı görünür, ama seçilebilecek alt küme sayısı astronomik. Bir nöronun ön aktivasyonu binlerce terimin toplamıdır; terimlerden doğru alt kümeyi çıkararak toplamı neredeyse istenen her değere itebilirsiniz. Lottery ticket literatürünün teorik kolu tam bunu ispatlamıştı: Malach ve arkadaşları yeterince geniş rastgele bir ağın, yalnızca pruning ile herhangi bir hedef ağı yaklaşıklayabileceğini gösterdi. Önceden eğitilmiş bir LLM, rastgele bir ağdan çok daha zengin bir başlangıçtır.
RL'in istediği şey zaten bir bastırma. Pass@k sonucu, doğru davranışın modelde mevcut olduğunu gösteriyor. Yapılması gereken, yanlış cevaba götüren yolların olasılığını düşürmek. Bu doğası gereği bir çıkarma işlemidir. Yeni bilgi öğretmek gereken bir görevde aynı yöntemin bu kadar iyi çalışmasını beklemeyiz; 1B'deki BBEH sonucu bu yönde zayıf bir işaret.
Fazlalık ölçekle artıyor. Küçük modellerdeki gerileme, silinebilecek yedek kapasitenin azlığıyla uyumlu. 1B'lik bir modelde her ağırlık daha fazla iş yükü taşır ve birini silmek başka bir şeyi bozar.
6.7 Eleştirel okuma
Kritik ablasyonlar eksik. Diğer projeksiyonlar (Q, K, V, O, up, down) denenmemiş. Silmek yerine aynı sayıda ağırlığı serbestçe eğitmek de denenmemiş. Dolayısıyla başlıktaki iki seçimin (silme ve gate) hangisinin işi yaptığını bu makaleden öğrenemiyoruz. Bölüm 5'in bulguları gate'in en verimli hedef olmayabileceğini düşündürüyor; bu gerilime Bölüm 9'da döneceğiz.
Rastgele baseline beklenmedik derecede güçlü. MTH, parametrelerin rastgele %0,05'ini eğitiyor ve Qwen-7B base modelde 51,24 alıyor; tam fine-tuning 51,89. Bu, Makale A ve B'nin "rastgele seyrek seçim RL altında öğrenmez" bulgusuyla doğrudan çelişiyor görünüyor. Makale C bu çelişkiye değinmiyor. Bölüm 9.3'te ayrıntılı ele alıyoruz, çünkü üç makale yan yana okunmadan görülemeyen bir sorun.
Doymuş sigmoid sorusu. Logitler 0,03 dolayında başlıyor ve α en az 1.000. Çarpımları 30 mertebesinde; sigmoid bu noktada neredeyse tam doymuş ve türevi 1e-13 düzeyinde. Gradyan pratikte yalnızca logiti sıfıra çok yakın olan ağırlıklara akabilir. Makale bu konuyu tartışmıyor. Bizim okumamız (doğrulanmadı): başlangıçtaki Gauss gürültüsü fiilen bir aday kümesi tanımlıyor ve eğitim yalnızca eşiğe yakın düşen logitleri oynatabiliyor. Eğer öyleyse, yöntemin başarısında Wanda başlangıcının ve gürültü genişliğinin rolü, hiperparametre tablosunun gösterdiğinden büyük olabilir. Tablo 7'deki sabit silme oranı bu okumayla uyumlu.
Eğitim ucuz değil. Yöntem saklamada parametre verimli, eğitimde değil. Her gate ağırlığı için bir logit ve optimizer durumu tutuluyor; 8B'lik modelde bu yaklaşık 1,9 milyar eğitilebilir parametre demek. Yazarlar belleğin tam fine-tuning'den düşük ama LoRA'dan yüksek olduğunu söylüyor ve logitleri bir aday kümesiyle sınırlamayı çözüm olarak öneriyor. Süre ya da FLOP karşılaştırması verilmemiş. Bölüm 4 ve 5'in skorları tam bu aday kümesini üretmek için kullanılabilir.
Küçük modeller. Özet cümlesindeki "tam fine-tuning ile eşit" iddiası 7B altında tutmuyor. Küçük dil modelleriyle çalışan biri için bu, makalenin en önemli dipnotu.
Baseline'lar dürüst. Artı hanesine yazılması gereken bir şey: tam fine-tuning'in learning rate'i ve KL katsayısı taranmış ve hiçbir ayar Deletion Tuning'i geçememiş. Yöntemin kendi hiperparametrelerine duyarlılığı da düşük: en iyi ayardan sapma Llama-8B'de 1,6, Qwen-7B'de 3,2 puanın içinde kalıyor.
7. Gradyansız yol: Weight-Space Programming
Takehi, Teoh, Zhang ve Khattab (MIT CSAIL, 2 Kasım 2026) önceki üç bölümün ortak varsayımını sorguluyor: hangi ağırlıkların değişeceğini bulmak için gradyan şart mı? Yazı, güçlü bir dil modelinin ağırlıkları doğrudan okuyup yazabildiğine dair sekiz vaka sunuyor. Yazarların kendi ifadesiyle bunlar "kıvılcımlar": bitmiş bir yöntem değil, erken kanıt.
Bu bölümün kanıt düzeyi önceki üçünden farklıdır ve böyle okunmalıdır. Kaynak hakemli bir makale değil, bir blog yazısı; sonuçlar baseline'lı deneyler değil, tek tek vakalar. Öte yandan tüm deney kayıtları açık, ve en çarpıcı sonuç (Qwen düzenlemesi) bağımsız olarak yeniden kurulup değerlendirilmiş.
7.1 Fikir
Ağırlıklar bugüne kadar üç yoldan üretildi: optimizasyonla (gradyan inişi), ağırlık üretmek üzere eğitilmiş başka ağlarla, ya da biçimsel bir programdan derleyerek. Sonuncusunun bilinen örneği Tracr: RASP dilinde yazılmış bir programı transformer ağırlıklarına çeviren bir derleyici. Weight-Space Programming dördüncü bir yol öneriyor: ağırlıkları, akıl yürüten genel amaçlı bir model yazsın.
Argümanın arka planı şu. Dil modelleri son yıllarda metin biçimindeki her şeyi optimize etmek için kullanıldı: prompt'lar, agent harness'leri, eğitim kodu. Bunun gerekçelerinden biri, metin üzerinde gradyan gibi ilkeli bir tırmanma yöntemi olmamasıydı. Ağırlıklar için ise gradyan vardı, o yüzden kimse akıl yürütmeyle ağırlık yazmayı denemedi. Yazı bu sınırın keyfi olduğunu öne sürüyor.
Deneylerin tamamında yazarların Astra adını verdiği bir model kullanılıyor. Küçük ağlarda ağırlıklar doğrudan bağlama sığıyor; büyük ağlarda model bir sandbox içinde kod çalıştırarak ağırlıkları inceliyor ve bazı deneylerde sınırlı sayıda forward pass hakkı alıyor.
7.2 Sekiz deney
| No | Tür | Ağ | Görev | Sonuç |
|---|---|---|---|---|
| 1 | Okuma | 4 PPO ajanı, aynı mimari, 17.253 ağırlık | Ham ağırlıklardan hangi oyunu oynadığını bul | 4/4 doğru, araçsız |
| 2 | Okuma | 3 difüzyon modeli, 23.824 ağırlık | Forward pass olmadan hangi şekli ürettiğini bul | 3/3 doğru |
| 3 | Okuma | 3 karakter düzeyi transformer, 7,2M parametre, giriş ve çıkış katmanları çıkarılmış | Eğitim dilini ve induction head'leri bul | 3/3 dil doğru; tüm induction head'ler bulundu, yanlış pozitif yok |
| 7 | Okuma | Gemma 3 270M, dürüst ve sycophantic iki kopya | Hangisinin sycophantic olduğunu bul | Yalnız ağırlıktan 4 denemede başarısız; attention pattern'leriyle 3/3 |
| 4 | Yazma | Kinetix'te başarısız bir PPO kontrolcüsü | Yerel minimuma takılmış policy'yi onar | Ağırlıkların %3,5'i değişti; başarı 0/256'dan 1.024/1.024'e |
| 5 | Yazma | MinAtar için boş ağlar | Sıfırdan, verisiz ve gradyansız ağırlık yaz | Üç oyunda da 100M adımlık PPO'yu geçti |
| 6 | Yazma | 9x9 Go için 1,48M parametreli ağ | Eğitimsiz ve aramasız bir Go ağı yaz | 50 forward pass ile, 20M oyunda eğitilmiş eş boyutlu PPO ağını yendi |
| 8 | Yazma | Qwen3.5-0.8B | Bilinen bir hatayı ağırlıklarda bul ve gider | Ağırlıkların %0,016'sı değişti; MATH-500 %7,9'dan %48,1'e |
7.3 Okuma: ağırlıklardan davranış çıkarmak
Okuma deneylerinde ilginç olan sonuçtan çok yöntem. Birinci deneyde model, ilk katmanın hangi giriş kanallarına yoğunlaştığına bakarak oyunu çıkarıyor: bir oyun ajanının ilk katmanı, gözlem uzayının hangi bölgesinin karar için önemli olduğunun bir haritasıdır. İkinci deneyde model şekilleri çerçeve olarak çiziyor, oysa difüzyon modelleri dolu şekiller üretiyor. Yazarlar bunu, modelin çıktıyı hesaplamak yerine ağırlık geometrisini analiz ettiğinin işareti olarak okuyor.
Üçüncü deney en zoru. Giriş ve çıkış katmanları çıkarıldığında ağırlıkların hangi karaktere karşılık geldiğini söyleyen sözlük gider; geriye yalnızca iç hesap kalır. Model yine de eğitim dilini buluyor. Romaji Japonca'yı, modelin karakter kümesinin darlığından (q, l, v, x yok) teşhis ediyor. Induction head'lerin (kopyalama yapan attention head'leri) hepsini yanlış pozitifsiz bulması ise, mekanistik yorumlanabilirlikte insanların elle yaptığı bir analizin otomatikleşebildiğini gösteriyor.
Yedinci deney sınırı çiziyor ve yazının en dürüst kısmı. Davranışsal bir özellik olan sycophancy'yi (kullanıcıya yaranma eğilimi) model yalnız ağırlıklara bakarak dört denemede de bulamıyor. Kendi yazdığı metinler üzerindeki attention pattern'lerini incelemesine izin verildiğinde üç çiftin üçünde de buluyor: sycophantic kopyada 10.2 numaralı head sorudaki sayılara değil, kullanıcının önerdiği cevaba bakıyor. Ders şu: yapısal özellikler (hangi oyun, hangi dil, hangi head) ağırlıklardan okunabiliyor; ince davranışsal farklar için activation space'e geçmek gerekiyor. Bölüm 2.1'deki ayrım burada somutlaşıyor.
7.4 Yazma: ağırlıkları elle kurmak ve onarmak
Sıfırdan yazılan ağlar. Beşinci deneyde model üç MinAtar oyunu için ağırlıkları sıfırdan yazıyor.
| Oyun | Elle yazılan ağ | PPO, 100M adım | PPO, 500M adım |
|---|---|---|---|
| Breakout | 517,4 | 15,8 | 25,3 |
| Seaquest | 53,1 | 5,6 | 88,9 |
| Asterix | 53,2 | 25,8 | 55,2 |
Breakout sonucu aykırı değer gibi görünüyor ama açıklaması basit: model ilk katmanı topun nereye düşeceğini hesaplayacak, ikinci katmanı raketi oraya götürecek şekilde yazmış. Bu, oyunun kapalı form çözümü. PPO aynı çözümü 500 milyon adımda bulamıyor. Seaquest ve Asterix'te ise böyle temiz bir çözüm yok ve uzun eğitilmiş PPO öne geçiyor ya da başa baş kalıyor. Genelleme şu: görevin açık bir algoritması varsa ağırlık yazmak optimizasyonu ezip geçebilir; yoksa optimizasyon hâlâ daha iyi.
Go deneyi aynı fikrin daha büyük ölçeği. 1,48 milyon parametreli ağ (243 giriş, altı adet 512'lik katman, 82 çıkış) tek tek yazılmıyor; model ağırlıkları üreten 336 satırlık bir Python programı yazıyor. Programın katmanlı bir mantığı var: özgürlük sayımı, taş yakalama, grup güvenliği. Hiç forward pass yapmadan yazılan sürüm, daha küçük iki PPO ağını oyunların yarısından fazlasında yeniyor. Bu deneyin asıl önemi ölçekleme stratejisinde: ağırlıkları doğrudan yazmak yerine ağırlık üreten kod yazmak, bağlam penceresi sınırını aşmanın yolu.
Onarım. Dördüncü deneyde bir PPO policy'si rampadaki arabayı hedefe götüremiyor; 256 denemede sıfır başarı. Model başarısızlığın nedenini açıklıyor ve tek bir düzenleme yapıyor: konum ve hızı okuyan, araba belirli bir şeridi geçince kendini kapatan küçük bir yan yol ekliyor. Ağırlıkların %3,5'i değişiyor, 1.024 test bölümünün tamamı başarılı oluyor. Gradyan inişinin yerel minimumdan çıkamadığı bir yerde, sorunu anlayan bir düzenleyici tek hamlede çıkıyor.
7.5 Qwen vakası: tek yön, yüz otuz bin ağırlık
Sekizinci deney bu yazının konusuyla en doğrudan ilgili olanı, çünkü gerçek bir dil modelinde yapılıyor.
Qwen3.5-0.8B'nin model kartında da belirtilen bilinen bir kusuru var: uzun üretimlerde döngüye giriyor. Baz modelde MATH-500 cevaplarının %93'ü 32.768 tokenlik sınıra çarpıyor; model cevabı bilse bile söyleyemeden token bütçesini tüketiyor. Astra bu davranışı 15. ve 19. katmanların MLP'lerinin residual stream'e yazdığı tek bir yöne kadar izliyor ve o yönü, her iki katmanda 64 çıkış sütunundan çıkarıyor. Değişen ağırlık sayısı 131.072: iki katman, katman başına 64 sütun, sütun başına 1.024 giriş. Modelin %0,016'sı.
| Ölçüm | Önce | Sonra |
|---|---|---|
| MATH-500 | %7,9 | %48,1 |
| GSM8K | %13,8 | %67,1 |
| IFEval | %21,0 | %62,3 |
| Token sınırına çarpan MATH-500 cevapları | %93 | %33 |
Bu sonuçlar modele 50 forward pass hakkı verildiğinde elde ediliyor. 10 ve 25 pass'te kazanım küçük kalıyor ve döngüler büyük ölçüde sürüyor. Yani bu, saf ağırlık okuması değil; ağırlık analizi ile az sayıda deneyin birleşimi.
Bu düzenlemeyi doğru sınıflandırmak önemli. Yapılan işlem yeni değil: residual stream'de bir yön bulup onu ağırlıklardan çıkarmak, refusal direction çalışmalarından (Arditi ve arkadaşları, 2024) ve rank-1 model düzenlemesinden (Meng ve arkadaşları, 2022) bilinen bir tekniktir. Yeni olan, teşhisi ve ameliyatı bir insan araştırmacının değil bir modelin yapması. Geometrik olarak da Bölüm 6'dan farklı bir nesne: Deletion Tuning seyrek ve yüksek ranklı bir silme yapıyordu, bu ise yoğun ve düşük ranklı (katman başına rank-1) bir çıkarma. İkisi de çıkarımsal, ikisi de modelin %0,05'inden azına dokunuyor, ama Bölüm 2.1'deki üç "küçüklük" ekseninin farklı köşelerinde duruyorlar.
7.6 Negatif sonuç ve asıl ders
Aynı yöntem Gemma 3 270M'e uygulandığında bir şey kazandırmıyor. Bu model nadiren döngüye giriyor ve MATH-500 skoru düzenlemelerden sonra %6,8'lik baz değerin yaklaşık bir puan çevresinde kalıyor. Yazarların çıkarımı yazının en önemli cümlesi: ağırlık düzenlemek, bir yeteneği gizleyen engeli kaldırabilir, ama modelde olmayan bir yeteneği ekleyemez.
Bu cümle Bölüm 6'daki pass@k tablosuyla aynı şeyi söylüyor. Llama-8B soruların %95'ini 128 denemede çözebiliyordu; RL doğru cevabın sıklığını artırdı. Qwen3.5-0.8B matematiği biliyordu; döngü onu söylemesini engelliyordu. İki durumda da küçük bir ağırlık değişikliği büyük bir skor farkı yarattı, çünkü yapılan iş bir yetenek inşa etmek değil, var olan bir yeteneğin önünü açmaktı.
7.7 Eleştirel okuma
Baseline yok. Qwen düzenlemesi için doğal karşılaştırmalar yapılmamış: repetition penalty gibi bir örnekleme ayarı aynı kazancı verir miydi? Bir insan araştırmacı aynı yönü aktivasyon farklarıyla ne kadar sürede bulurdu? Yazarlar sonuçların belirli örnekleme ayarlarına ve benchmark protokollerine bağlı olduğunu kendileri not ediyor.
Seçilmiş vakalar. Sekiz deneyin kaç denemeden seçildiği bilinmiyor. Yazarlar standart bir benchmark ve değerlendirme düzeneği kurduklarını ama henüz tamamlamadıklarını söylüyor; o gelene kadar bu sonuçlar varlık ispatı düzeyinde.
Ölçek. En büyük tam okuma 7,2 milyon parametrede; 0,8 milyarlık modelde yapılan iş tek bir bilinen hatanın izini sürmek. Milyarlarca parametreli bir modelde bilinmeyen bir sorunu ağırlıklardan bulmak hâlâ gösterilmiş değil. Bağlam uzunluğu ve araç verimsizliği yazarların kendi saydığı kısıtlar.
Modelin kendi iddiaları. Yazarlar Astra'nın küçük kazanımlar hakkındaki kendi beyanlarını kanıt saymadıklarını belirtiyor. Bu önemli bir metodolojik not: ağırlık düzenleyen bir ajanın "düzelttim" demesi, bağımsız ölçümün yerini tutmaz.
8. Kendi doğrulamamız: iddiaları küçük bir modelde sınamak
Üç makalenin ana iddialarını 74.624 parametreli bir modelde sıfırdan test ettik. Sınanan sekiz iddianın dördü makalelerle aynı yönde çıktı, dördü çıkmadı ve bir test makalelerde olmayan bir sonuç verdi: Fisher ile seçilen maske, modele yeni bir şey öğretilirken rastgele maskeden de kötü.
Bu bölüm bir replikasyon değildir. Oyuncak bir modelde bir iddianın tutması onu gerçek modeller için ispatlamaz, tutmaması da çürütmez. Amacı başka: hangi iddiaların matematiksel zorunluluk, hangilerinin gerçek dil modellerine özgü ampirik olgu olduğunu ayırmak. Küçük bir modelde her beklenti örneklemesiz, tam olarak hesaplanabildiği için bu ayrımı yapmak mümkün.
8.1 Düzenek
Model. 200 bağlam, her biri 32 boyutlu bir embedding; 128 nöronlu tek bir tanh hidden layer; 500 tokenlik çıkış. Toplam 74.624 parametre: embedding %8,6, giriş projeksiyonu %5,5, çıkış projeksiyonu %85,8.
Dil. Bağlamlar 20 kümeye ayrılıyor. Her bağlamın beş makul devamı var (olasılıklar 0,50, 0,25, 0,12, 0,08, 0,05) ve aynı kümedeki bağlamlar aynı token havuzunu paylaşıyor. Sözlüğün yarısı hiçbir bağlamda makul değil; model bu tokenleri üretmeyi hiç öğrenmiyor. Model bu dağılıma KL 0,0006 olana kadar ön eğitiliyor.
Görevler. İki görev, post-training'in iki ayrı türünü temsil ediyor.
Tercih değiştirme: model her bağlamda en olası token yerine ikinci en olası tokeni üretmeli. Başlangıç başarısı 0,25. Doğru cevap modelin dağılımında zaten var; yapılması gereken olasılık kütlesini kaydırmak. Bu görev hem RL ile (16 bağlam, bağlam başına 8 örnek, ikili ödül, grup ortalaması baseline) hem SFT ile (etiket olarak hedef token) eğitiliyor.
Yeni token: model her bağlamda, daha önce hiç üretmediği bir tokeni üretmeli. Başlangıç başarısı 0,00. Bu, modelde olmayan bir davranışı eklemek demek ve doğası gereği off-policy; yalnızca SFT ile eğitilebilir.
Maskeler. Dört seçim yöntemi aynı bütçede karşılaştırılıyor: Fisher (modelin kendi örneklerinden tam hesaplanan diyagonal Fisher), görev gradyanı (başlangıçtaki beklenen görev gradyanının mutlak değeri), ağırlık büyüklüğü ve rastgele. İkinci ve üçüncüsü, Makale A'nın karşılaştırmadığı baseline'lar.
Ölçümler. Başarı, eğitim bağlamlarında hedef tokenin ortalama olasılığı. Yan hasar, eğitimde hiç kullanılmayan dört kümedeki 48 bağlamda modelin çıktı dağılımının başlangıca göre KL kayması; unutmanın bir vekili. Eğitim Adam ile, learning rate 3e-3, 1.500 adım, üç seed.
8.2 Test 1: Fisher sınırı tutuyor mu, ne kadar sıkı?
Makale A'nın eşitsizliğini dokuz farklı eğitim sinyali için, 74.624 koordinatın her birinde tam olarak hesapladık. İhlal sayısı sıfır; bu beklenen sonuç, çünkü eşitsizlik bir teorem. İlginç olan sıkılığı: gerçek gradyanın sınıra oranı en iyi koordinatta 0,21, medyan koordinatta on binde bir mertebesinde. Sınır doğru ama çoğu koordinat için dört basamak gevşek. Fisher küçük gradyanı garanti ediyor, ama gradyanın ne kadar küçük olacağını tahmin etmiyor.
Asıl soru, Fisher'ın gradyanın yerini bulup bulmadığı. Makale A'nın ölçüsünü kullandık: Fisher'ı en yüksek %1 koordinat, gradyanı en büyük %1 koordinatın ne kadarını içeriyor?
| Eğitim sinyali | Sinyal ölçeği E[a²] | Fisher'ın ilk %1'inin isabeti |
|---|---|---|
| RL, on-policy | 0,19 | %58 |
| SFT, modelin kendi dağılımının keskinleştirilmişi | 0,07 | %55 |
| SFT, hedef = en olası token | 1,0 | %67 |
| SFT, hedef = 2. olası token | 3,0 | %58 |
| SFT, hedef = 5. olası token | 19 | %24 |
| SFT, hedef = 20. olası token | 150.000 | %19 |
| SFT, hedef = 100. olası token | 470.000 | %21 |
| SFT, hedef = hiç üretilmemiş token | 500.000 | %14 |
Rastgele beklenti %1. Makale A'nın Qwen3-1.7B'de ölçtüğü değer %47.
Tablo, Makale A'nın merkezi iddiasını temiz biçimde doğruluyor. Eğitim sinyali modelin kendi dağılımına yakınken (ilk dört satır) Fisher, en büyük gradyanlı koordinatların yarısından fazlasını buluyor. Hedef modelin makul bulduğu beş tokenin dışına çıktığı anda isabet üçte birine düşüyor ve sinyal ölçeği beş basamak büyüyor. Ki-kare terimi makaledeki soyut bir çarpan değil; on-policy ile off-policy arasındaki farkın sayısal karşılığı.
İsabet neden düşüyor? Bir tokenin çıkış sütununun Fisher'ı, o tokenin olasılığıyla orantılı. Model bir tokeni hiç üretmiyorsa, o tokeni üretmek için değişmesi gereken ağırlıkların Fisher'ı sıfıra yakın. Fisher modelin şu an ne yaptığını ölçer; ne yapması gerektiğini bilemez.
8.3 Test 2: on-policy görevde hangi maske çalışıyor?
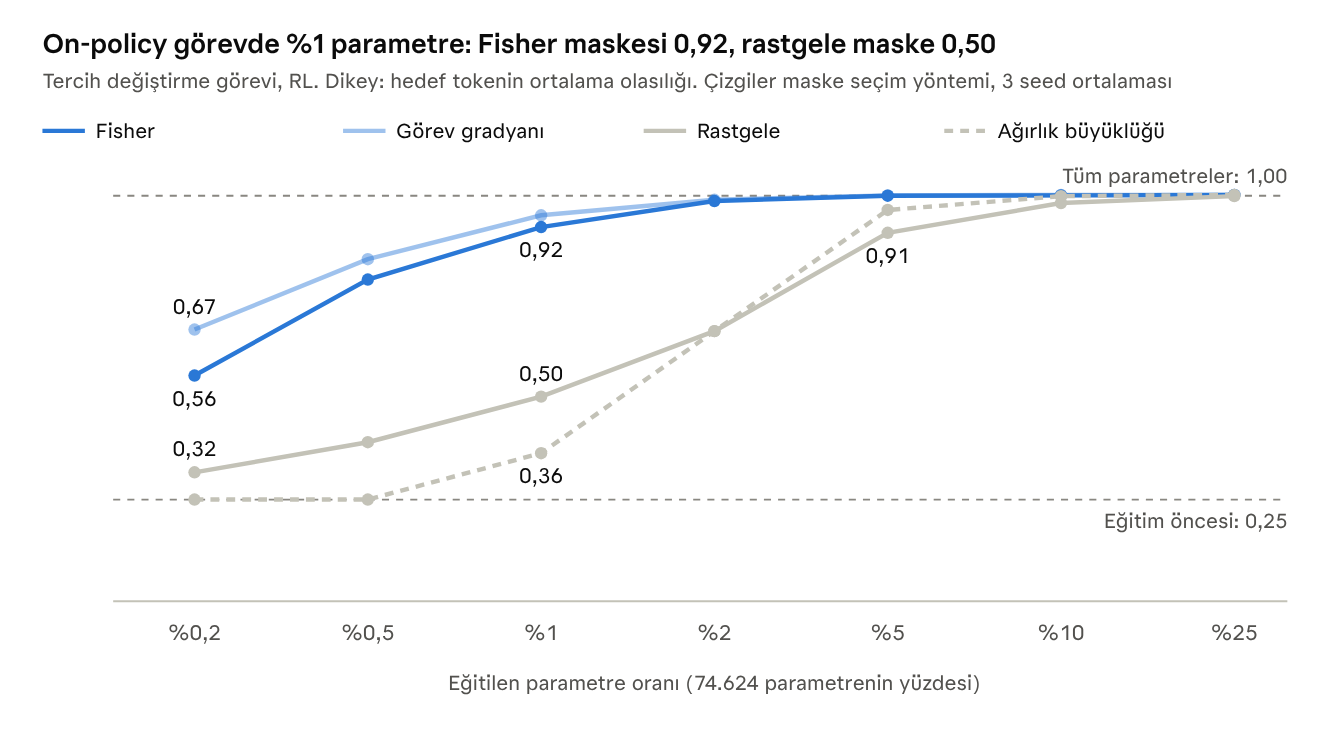
Makale A'nın ikinci iddiası da tutuyor: parametrelerin %1'iyle Fisher maskesi tam eğitim kazancının %90'ını geri alıyor (0,92; tam eğitim 1,00, başlangıç 0,25), rastgele maske %34'ünü. Makalenin gerçek modeldeki rakamları %96 ve %25.
Makalede olmayan iki sonuç var.
Görev gradyanı Fisher'ı her bütçede geçiyor. Fark en küçük bütçede belirgin (0,67'ye karşı 0,56) ve bütçe büyüdükçe kapanıyor. Bu, Bölüm 4.4'teki eleştirinin somut hali: Fisher'ın özel bir yanı yok, görevi bilen bir skor en az onun kadar iyi. Fisher'ın tek avantajı görev verisi gerektirmemesi.
Ağırlık büyüklüğü rastgeleden kötü. %0,5 bütçede büyüklük maskesi hiçbir şey öğrenmiyor (0,25), rastgele maske 0,39'a çıkıyor. Büyük ağırlıklar modelin mevcut davranışı için önemli olanlar; değişmesi gerekenler değil. Makale C'nin geometri analizindeki "RL ana ağırlıklardan kaçınıyor" bulgusuyla aynı yönde.
Gerçek modellerden bir fark da var: burada rastgele maske bütçeyle düzgün biçimde iyileşiyor. Makale B'deki gibi dümdüz baz çizgisinde kalmıyor. Bu fark Bölüm 9.3'te ele alınıyor.
8.4 Test 3: modele yeni bir şey öğretirken Fisher maskesi
Aynı dört maskeyi, modelin hiç üretmediği bir tokeni öğretme görevinde denedik.
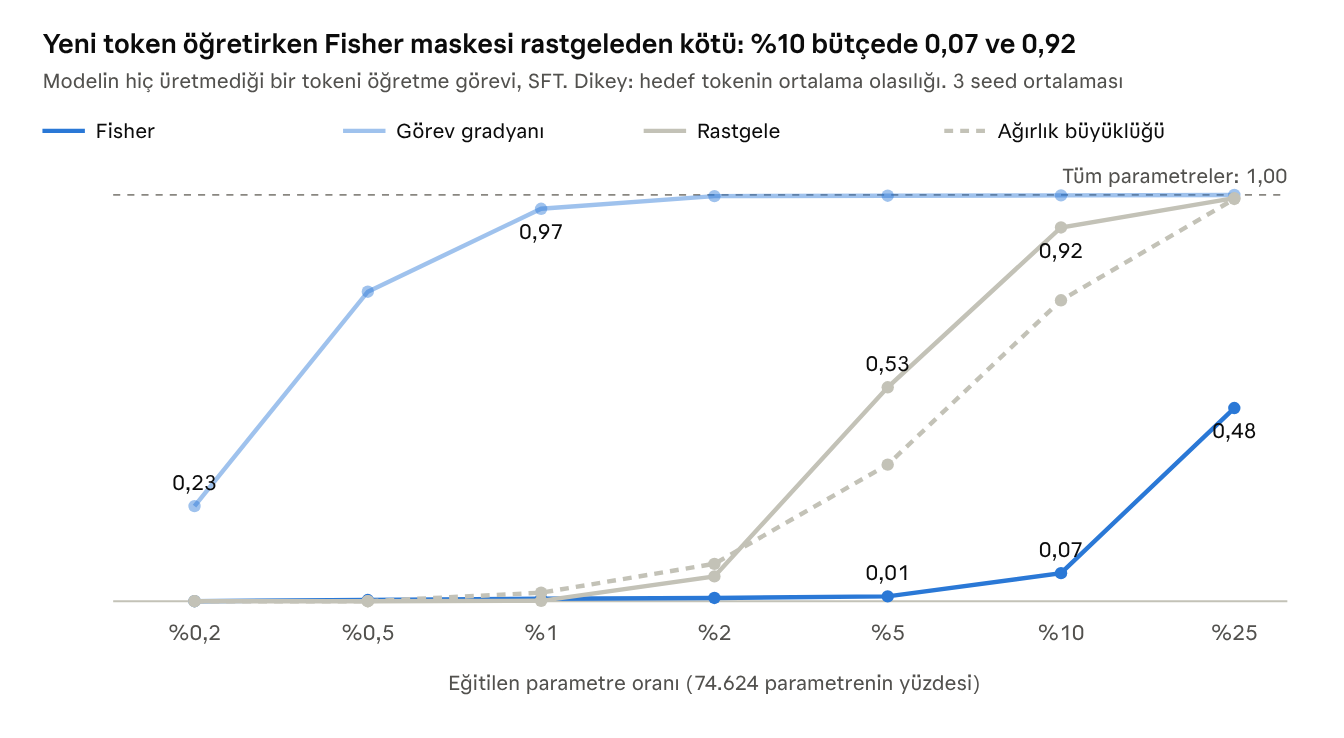
Bu bölümün en net sonucu bu. Fisher maskesi parametrelerin %10'unu eğitirken bile 0,07'de kalıyor; aynı bütçede rastgele maske 0,92. Görev gradyanı maskesi ise %1 bütçeyle 0,97'ye ulaşıyor. Fisher yalnızca işe yaramamakla kalmıyor, sistematik olarak yanlış yere bakıyor: gereken ağırlıklar tam da Fisher'ın "önemsiz" dediği ağırlıklar.
Bu sonuç üç makalenin hiçbirinde yok, ama üçünü de bağlıyor.
Makale A'nın sınırının off-policy'de gevşemesi, pratikte Fisher maskesinin tersine dönmesi demek. Yazarların "Fisher seçimini genel bir yöntem olarak önermiyoruz" çekincesi yerinde ve önemli.
Makale B'nin GPQA sonucundaki açıklanmamış anomali (Fisher skoru baz seviyesinde, gradyan skoru ve rastgele üstünde) bunun gerçek modeldeki izi olabilir. O deney SFT ile, modelin dağılımından uzak bir veride yapılmıştı. Bu bir hipotez; makaledeki skor görev kaybıyla hesaplandığı için birebir aynı mekanizma olmayabilir.
Blog yazısının "düzenleme engeli kaldırır, yetenek eklemez" cümlesinin maske dilindeki karşılığı bu: modelin kendi duyarlılığına bakarak seçilen ağırlıklar, var olan davranışları yeniden ağırlıklandırmaya yarar, yeni davranış inşa etmeye değil.
Pratik sonuç: seyrek post-training için maske seçecekseniz, görev gradyanına dayalı skor (Makale B'nin Ŝ'si) her iki durumda da çalışan tek seçenek. Fisher yalnızca görevin on-policy olduğundan eminseniz güvenli.
8.5 Test 4: SFT ile RL arasındaki fark
Makale B'nin ana iddiasını test etmek için aynı görevi (tercih değiştirme) hem RL hem SFT ile eğittik. İddia tutmadı: maske türlerinin sıralaması ve aralarındaki farklar iki rejimde neredeyse aynı.
| Bütçe %1 | Fisher | Görev gradyanı | Rastgele |
|---|---|---|---|
| RL | 0,92 | 0,95 | 0,50 |
| SFT | 0,91 | 0,94 | 0,48 |
Nedeni gradyan yapısında. Makale B'nin üç ölçüsünü 64 mini-batch gradyanı üzerinde hesapladık:
| Ölçü | SFT | RL | Makale B (Qwen2.5-1.5B, SFT / GRPO) |
|---|---|---|---|
| Adımlar arası kosinüs | 0,11 | 0,08 | 0,76 / 0,04 |
| Efektif rank | 30 | 35 | 2,6 / 21,8 |
| Birikim verimi | 0,35 | 0,31 | 0,90 / 0,28 |
Oyuncak modelin RL değerleri gerçek modelinkine yakın. Fark SFT'de: gerçek modelde SFT gradyanları adımdan adıma aynı yöne bakıyor (0,76), bizde bakmıyor (0,11). Sebep açık: bizim modelde her bağlamın kendi embedding satırı var ve farklı mini-batch'ler farklı parametrelere dokunuyor. Gerçek bir dil modelinde ise bütün SFT örnekleri aynı ağırlıklardan geçiyor ve ortak bir yönü (örneğin bir cevap formatını) birlikte itiyor.
Bu, olumsuz ama öğretici bir sonuç. Makale B'nin SFT ve RL karşıtlığı rejimlerin matematiksel bir özelliği değil; SFT verisinin örnekler arasında paylaşılan bir yapı taşımasına bağlı. Veri heterojense (her örnek başka bir şey öğretiyorsa) SFT de RL gibi davranır ve yerleşim SFT'de de önem kazanır. Makale B'nin instruct modellerde karşıtlığın kaybolduğunu bildirmesi ve zor SFT görevinde (GPQA) seyrek B'nin geride kalması bu okumayla uyumlu.
Bir ölçü ise makaleyle aynı yönde çıktı. Koordinat başına işaret tutarlılığı (64 mini-batch'te gradyan işaretinin ortalamasının mutlak değeri) bütün koordinatlar üzerinden SFT'de 0,36, RL'de 0,04. SFT her parametreye küçük ama tutarlı bir itme uyguluyor; RL parametrelerin çoğuna rastgele işaretli gürültü veriyor. En yüksek gradyanlı %1'de ise iki rejim aynı (0,18 ve 0,19).
8.6 Test 5: yan hasar
Eğitimde hiç kullanılmayan bağlamlardaki KL kayması, tercih değiştirme görevinde:
| Yöntem | RL: başarı | RL: yan hasar | SFT: başarı | SFT: yan hasar |
|---|---|---|---|---|
| Tüm parametreler | 1,00 | 0,41 | 1,00 | 2,19 |
| Fisher maskesi, %5 | 1,00 | 0,04 | 1,00 | 0,03 |
| Görev gradyanı maskesi, %5 | 1,00 | 0,09 | 1,00 | 0,07 |
| Rastgele maske, %5 | 0,91 | 0,25 | 0,90 | 0,58 |
| Ağırlık büyüklüğü maskesi, %5 | 0,96 | 0,41 | 0,96 | 1,01 |
Üç gözlem.
Doğru seçilmiş seyrek maske, aynı başarıda on kat az yan hasar veriyor. Fisher maskesi %5 bütçeyle tam eğitimin başarısına ulaşıyor ve kayma 0,41'den 0,04'e düşüyor. Makale C'nin unutma bulgusuyla aynı yönde ve onun söylemediği bir şeyi ekliyor: unutmayı azaltan, silme işleminin kendisi olmayabilir; dokunulan ağırlık kümesinin küçük ve isabetli olması yetebilir. Makale C bu ikisini ayıracak ablasyonu yapmamıştı.
Seyreklik tek başına yetmiyor. Rastgele ve büyüklük maskeleri aynı bütçede altı ile on kat fazla yan hasar veriyor. Makale C'de rank-1 LoRA'nın tam fine-tuning'den çok unutmasıyla aynı ders: az parametre değil, doğru parametre.
SFT, aynı başarı için RL'in beş katı kayma üretiyor (2,19'a karşı 0,41). Bu, Makale A'daki sinyal ölçeği çarpanının doğrudan sonucu. RL'de sinyal ödülün varyansıdır ve model başarılı olduğunda kendiliğinden sıfıra gider; RL kendi kendini sınırlar. SFT'de model hedefi %99 olasılıkla üretse bile kalan %1 için itmeye devam eder. Bu kıyas tam adil değil (SFT'yi erken durdurmak farkı azaltırdı), ama mekanizma gerçek.
8.7 Test 6: yalnızca silerek öğrenmek
Makale C'nin fikrini en basit haliyle denedik: ağırlıklar donuk, her ağırlık için bir logit, forward pass'te sert maske, gradyan straight-through ile. Bu makalenin parametrizasyonu değil (onlar yumuşak maske ve Wanda başlangıcı kullanıyor), dolayısıyla sonuç bir alt sınır olarak okunmalı.
| Ayar | Silinen ağırlık oranı | Başarı (başlangıç 0,25) | Yan hasar |
|---|---|---|---|
| Seyreklik cezası var, embedding hariç | %0,2 ile %0,5 | 0,43 ile 0,44 | 0,07 ile 0,19 |
| Seyreklik cezası var, embedding dahil | %0,3 ile %0,6 | 0,57 ile 0,61 | 0,04 ile 0,11 |
| Seyreklik cezası yok, embedding dahil | %31 | 1,00 | 2,20 |
Yalnızca silerek görevi tamamen çözmek mümkün, ama ağırlıkların üçte birini silmek gerekiyor ve yan hasar tam fine-tuning'den büyük. Binde birkaçlık silmeyle kazancın dörtte biri ile yarısı alınıyor. Yani bu ölçekte "%0,05 yeter" sonucu çıkmıyor.
Bu, Makale C'nin küçük modellerdeki gerilemesiyle ve Bölüm 6.6'daki fazlalık hipoteziyle uyumlu: 75 bin parametreli bir modelde silinebilecek yedek kapasite yok denecek kadar az. Ama ayarımız kaba ve tek mimaride; bu sonuç hipotezi desteklemekten çok onunla çelişmiyor.
8.8 Tutmayan bir mekanizma: token duyarlılıkları
Makale A, Fisher'ın neden küçük olduğunu olası tokenlerin bir parametreye benzer tepki vermesiyle açıklıyordu ve gerçek / düzgün dağılım oranını 0,16 buluyordu. Aynı oranı hidden layer nöronları için hesapladık: 1,26. Birin üstünde; yani bizim modelde olası tokenler rastgele tokenlerden daha farklı tepki veriyor.
Bu da öğretici. Makale A'nın token düzeyi mekanizması softmax'in matematiğinden gelmiyor; gerçek dilin yapısından geliyor. Gerçek bir modelde bir bağlamın olası devamları anlamca yakın kelimelerdir (çay, kahve, su) ve çıkış vektörleri birbirine benzer. Bizim yapay dilimizde beş makul token rastgele seçildi ve aralarında hiçbir benzerlik yok. Seyrekliğin bu kısmı dil modellerine özgü ampirik bir olgu.
8.9 Bilanço
| İddia | Kaynak | Oyuncak modelde | Okuma |
|---|---|---|---|
| Fisher beklenen gradyanı sınırlar | A | Tuttu, 0 ihlal; ama sınır çok gevşek | Matematiksel zorunluluk |
| Fisher on-policy'de gradyanın yerini bulur, off-policy'de bulamaz | A | Tuttu: isabet %58'den %14'e | Mimari bağımsız görünüyor |
| Fisher maskesi rastgele maskeyi ezer (on-policy) | A | Tuttu: %1 bütçede 0,92'ye karşı 0,50 | Mimari bağımsız görünüyor |
| Yerleşim RL'de önemli, SFT'de önemsiz | B | Tutmadı: ikisinde de önemli | SFT verisinin ortak yapısına bağlı |
| Rastgele yerleşim RL'de hiç öğrenmez | B | Tutmadı: yavaş ama öğreniyor | Ölçeğe ve gürültü düzeyine bağlı |
| Az silme tam eğitime yeter | C | Tutmadı: kısmi kazanç | Fazlalık gerektiriyor; ölçekle ilgili |
| Seyrek ve isabetli güncelleme az unutur | C | Tuttu: on kat az yan hasar | Silmeye özgü olmayabilir |
| Olası tokenler benzer duyarlılık taşır | A | Tutmadı: oran 1,26 | Gerçek dilin özelliği |
| Fisher maskesi yeni davranış öğretirken başarısız | yeni | Rastgeleden kötü | Gerçek modelde sınanmalı |
9. Sentez: üç makale birlikte ne söylüyor
Üç makale dört noktada birbirini doğruluyor, üç noktada ayrışıyor. Ayrışmalardan biri (rastgele seyrek seçimin çalışıp çalışmadığı) makalelerin hiçbirinde tartışılmıyor ve ancak yan yana okununca görünüyor.
9.1 Yan yana
| A: Fisher merceği | B: LoRA yerleşimi | C: Deletion Tuning | Blog: WSP | |
|---|---|---|---|---|
| Soru | Neden seyrek? | Hangi parametreler? | Ne kadar azı yeter? | Gradyan şart mı? |
| Seçim | Eğitimden önce; modelin kendi örneklerinden Fisher | Eğitimden önce; 50 pass'lik görev gradyanı | Eğitim sırasında öğreniliyor; Wanda başlangıcı | Modelin akıl yürütmesi ve az sayıda forward pass |
| İşlem | Seçilen ağırlıkları serbestçe eğit | LoRA-B'nin seçilen girişlerini eğit | Gate ağırlıklarını sil | Bir yönü çıkar ya da ağırlığı elle yaz |
| Dokunulan kısım | Tüm ağırlıkların %0,05 ile %5'i | 1.000 ile 100.000 giriş | Tüm ağırlıkların %0,05'inden azı | %0,016 (Qwen vakası) |
| Modeller | Qwen3-1.7B base | Qwen2.5 1.5B-7B base; Llama 3B-8B instruct | Llama 1B-8B instruct; Qwen2.5 0.5B-14B base; Qwen3 30B MoE | Qwen3.5-0.8B ve küçük ağlar |
| Rejimler | RL, OPD | SFT, GRPO | GRPO, SFT, OPD | Eğitim yok |
| Unutma ölçümü | Yok | Yok | Var, tek görev sonrası | Yok |
| Hesap tasarrufu | Gösterilmedi | Gösterilmedi | Saklamada var, eğitimde yok | Uygulanamaz |
| En zayıf nokta | Tek model; yalnız rastgele baseline | Karşıtlık base modellere özgü | Ablasyon yok; 7B altında geride | Vaka düzeyinde kanıt |
9.2 Birleştikleri dört nokta
On-policy sinyal az sayıda koordinata düşer. A bunu teorik olarak gösteriyor, B ölçüyor (girişlerin %0,05'i gradyan enerjisinin %8 ile %15'ini taşıyor), C sonucunu kullanıyor. Üç bağımsız ekip, üç farklı yöntem, aynı olgu.
Bu koordinatlar eğitimden önce ve ucuza bulunabilir. A için 800 soru ve birer model cevabı, B için 50 forward-backward pass ve 10 saniye yetiyor. İki skor aynı aileden: B'nin F̂'si bir Fisher tahmini, A'nın sınırı ise B'nin Ŝ'sine üst sınır koyuyor.
Değişiklik yetenek eklemiyor, var olan yeteneğin kullanımını ayarlıyor. C'nin pass@k tablosu (baz model 128 denemede soruların %95'ini çözüyor), blogun negatif sonucu (döngü sorunu olmayan modelde kazanç yok) ve bizim Test 3'ümüz (Fisher maskesi yeni token öğretemiyor) aynı şeyi üç farklı dille söylüyor.
Dokunulan ağırlıklar modelin en büyük ya da en merkezi ağırlıkları değil. C'de RL güncellemesinin ana ağırlıklarla örtüşmesi rastgelenin altında. Bizim deneyde ağırlık büyüklüğüne göre seçilen maske rastgeleden kötü. Post-training modelin omurgasına değil, ikincil bağlantılarına dokunuyor.
9.3 Ayrıştıkları üç nokta
Ayrışma 1: rastgele seyrek seçim çalışır mı?
| Makale | Düzenek | Rastgele seçim | Tam eğitim | Başlangıç |
|---|---|---|---|---|
| A | Qwen3-1.7B base, rastgele %0,05, MATH-500 | 23,21 | 56,41 | 22,65 |
| B | Qwen2.5-1.5B base, rastgele 10.000 LoRA-B girişi, GSM8K | 9,8 | 62,8 | 9,5 |
| C | Qwen2.5-7B base, rastgele %0,05 (MTH), altı benchmark | 51,24 | 51,89 | bu okumada not edilmedi |
| C | Qwen2.5-0.5B base, rastgele %0,05 (MTH) | 20,16 | 19,01 | bu okumada not edilmedi |
A ve B'de rastgele seçim hiçbir şey öğrenmiyor. C'de aynı oran, aynı model ailesi, yine base modeller; ama rastgele seçim tam fine-tuning ile başa baş, 0.5B'de önde. Üç makale de bu farkı görmüyor, çünkü her biri kendi rastgele baseline'ına bakıyor.
Üç aday açıklama var; üçü de bizim okumamız.
Learning rate. A, maskeli eğitimde tam fine-tuning ile aynı learning rate'i kullanıyor (5e-7); B'de 1e-6. Adam altında bir parametrenin adımı gradyanın büyüklüğünden değil learning rate'ten gelir; 1.000 adımda bir parametre en fazla binde bir mertebesinde yer değiştirebilir. Bu kadar küçük bir hareketin çıktıyı etkilemesi için parametrenin çok duyarlı olması gerekir, yani Fisher'ının yüksek olması. Rastgele bir alt küme bu learning rate ile hareket eder ama iz bırakmaz. Seyrek eğitim için ayrıca ayarlanmış bir baseline daha yüksek bir learning rate ile bunu telafi edebilir. C'nin MTH için kullandığı learning rate'i bilmiyoruz.
Bütçe. B'nin bütçesi en fazla 50.000 giriş. C'de 7B'lik modelin %0,05'i yaklaşık 3,8 milyon ağırlık: yüz katın üzerinde. Bizim deneyde de rastgele maske bütçeyle düzgün biçimde iyileşiyordu (0,32'den 0,91'e); keskin bir başarısızlık yoktu.
Ölçek. C'nin rastgele baseline'ı büyük modelde iyi; fazlalık arttıkça rastgele bir alt kümenin işe yarar ağırlık içerme ihtimali artar. Ama 0.5B sonucu bu açıklamayı zayıflatıyor.
Bizce en güçlü aday birincisi, ve doğruysa A ve B'nin iddiasının yeniden yazılması gerekir: "rastgele seçim öğrenmez" değil, "bilinçli seçim aynı learning rate ve bütçede çok daha verimlidir". Bu daha zayıf ama daha savunulabilir bir iddia. Bölüm 11'deki ilk deney bunu sınıyor.
Ayrışma 2: gate hedef mi, değil mi?
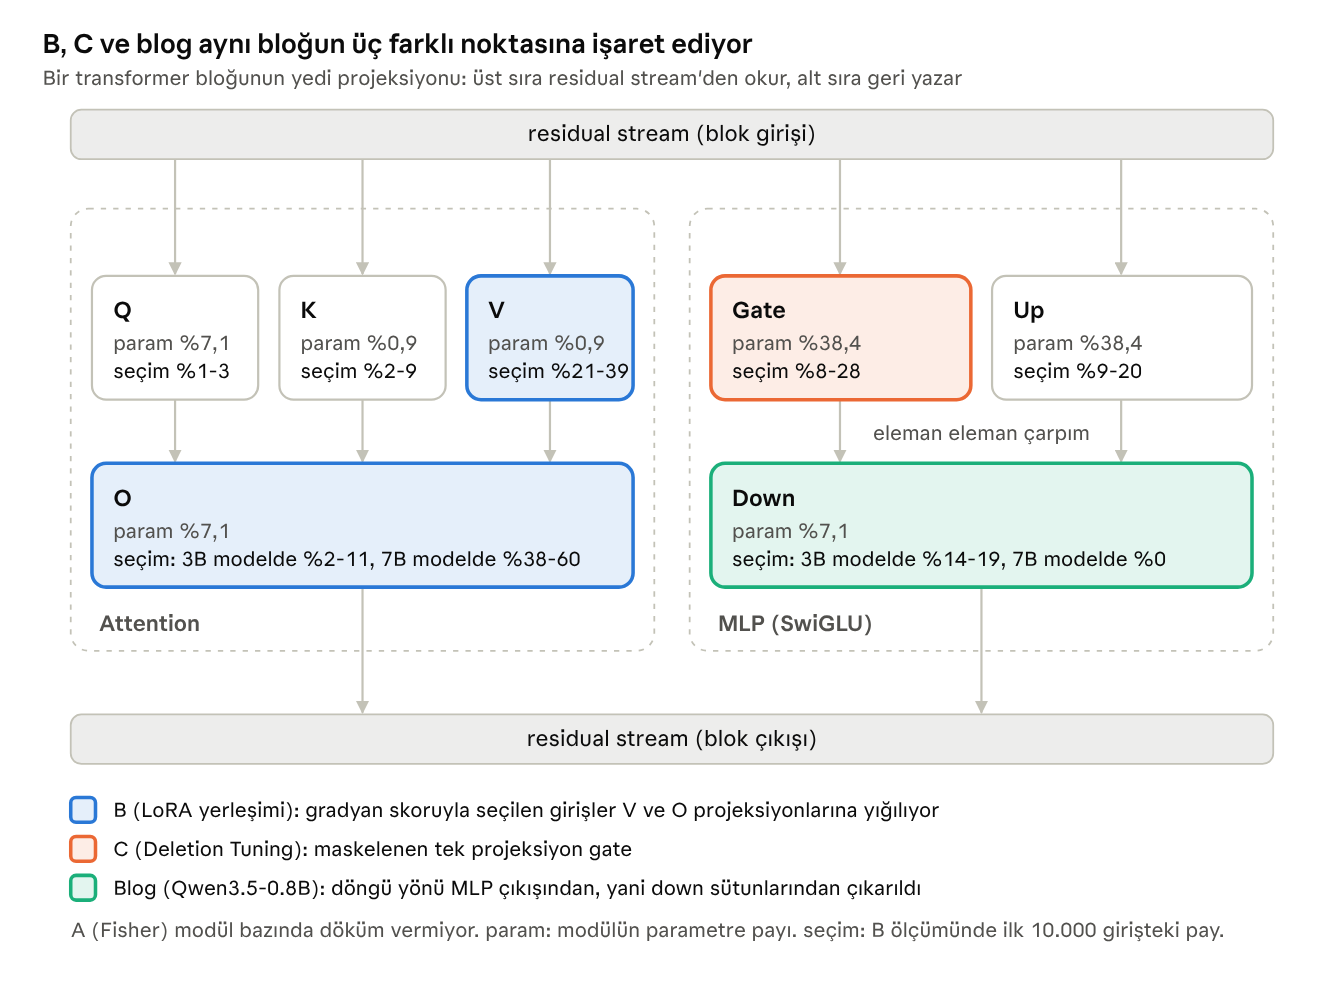
B, gradyan skoruyla seçim yapınca gate'in parametre payının çok altında kaldığını buluyor ve bunu gate'in residual stream'e doğrudan yazmamasıyla açıklıyor. C ise yalnızca gate'i hedefliyor ve tam fine-tuning'e yetişiyor. İkisi aynı anda doğru olabilir, çünkü aynı şeyi ölçmüyorlar.
İşlem farklı. B'de bir gate girişi, dondurulmuş rastgele A'nın tanımladığı bir alt uzayda toplamalı bir düzeltmedir. C'de ise tek bir gerçek ağırlığın silinmesidir. "LoRA-B'nin gate girişlerine az gradyan geliyor" ile "tek tek gate ağırlıklarını silmek işe yaramıyor" aynı önerme değil.
Skor ölçeğe duyarlı. B'nin seçimi ham gradyan büyüklüğüyle, bütün modüller arasında global yapılıyor. Gate'e gelen gradyan bir aktivasyon fonksiyonunun türevinden ve up ile çarpımdan geçtiği için büyüklük olarak küçük olabilir. B'nin kendi eki de gate'in işaret tutarlılığının V ve O kadar yüksek olduğunu söylüyor. Gate az seçiliyor olabilir çünkü gradyanı küçük, önemsiz olduğu için değil. C'nin optimizer'ı ise logit başına ölçekten bağımsız adım atıyor.
C alternatifi denemedi. V ya da O ağırlıklarını silmek gate'ten daha iyi sonuç verebilir. B'nin bulgusu bunun denenmeye değer olduğunu söylüyor.
Ayrışma 3: SFT'de ne oluyor?
B'ye göre SFT'de yerleşim önemsiz. A'ya göre SFT ancak verisi modele yakınsa seyrek. C'de on-policy distillation RL'in dört ile yedi katı silme gerektiriyor. Bizim deneyde SFT ile RL arasında fark çıkmadı. Bu dört gözlemi "SFT'ye karşı RL" ekseninde uzlaştırmak mümkün değil. Doğru eksen o değil.
Önerdiğimiz okuma: belirleyici olan rejimin adı değil, iki ayrı özellik.
| Sinyal örnekler arasında tutarlı | Sinyal örnekler arasında gürültülü ya da heterojen | |
|---|---|---|
| Sinyal modelin dağılımına yakın | Güncelleme seyrek; yerleşim az önemli. Örnek: near-policy SFT | Güncelleme seyrek; yerleşim belirleyici. Örnek: RL, B'nin base model sonuçları |
| Sinyal modelin dağılımından uzak | Güncelleme yoğun; herhangi bir alt küme birikir ama kapasite gerekir. Örnek: B'nin Alpaca ve GPQA sonuçları | En zor durum; Fisher yanıltır, görev gradyanı gerekir. Örnek: bizim yeni token görevi |
Birinci eksen A'nın ki-kare terimi, ikincisi B'nin adımlar arası kosinüsü. RL her zaman üst satırın sağ hücresindedir; SFT ise verisine göre dört hücrenin herhangi birine düşebilir. B'nin "SFT'de önemsiz" bulgusu sol sütuna, bizim deneyin "SFT'de de önemli" bulgusu sağ sütuna ait.
9.4 A ile B'yi birleştiren küçük bir türetim
A beklenen gradyanın büyüklüğüne, B işaretinin tutarlılığına bakıyor. İkisinin nasıl birleştiğini görmek için Adam'ın ne yaptığını yazmak yetiyor. Aşağıdaki türetim sezgiseldir ve bize aittir.
Adam her koordinatta gradyanın ortalamasını karekök ikinci momentine böler. T adımda bir koordinatın toplam yer değiştirmesi yaklaşık olarak learning rate, adım sayısı ve sinyal-gürültü oranının çarpımıdır:
Bu yer değiştirmenin modelin çıktı dağılımını ne kadar oynattığı ise parametrenin duyarlılığına, yani Fisher'ının kareköküne bağlıdır. İkili ödül gibi sınırlı bir sinyalde gradyanın ikinci momenti Fisher ile kabaca orantılı olduğundan, karekökler sadeleşir:
Sonuç: Adam altında bir koordinatın modelin davranışına katkısı, o koordinatın beklenen gradyanının mutlak değeriyle orantılıdır. Bu tam olarak B'nin Ŝ skoru. A'nın eşitsizliği ise bu niceliğe Fisher üzerinden bir üst sınır koyuyor.
Bu türetim üç gözlemi birden açıklıyor. Birincisi, B'de Ŝ ile F̂'nin neden birbirine yakın ama Ŝ'nin küçük bütçelerde ve zor görevde neden daha güvenilir olduğunu: F̂ üst sınırı ölçüyor, Ŝ niceliğin kendisini. İkincisi, bizim deneyde görev gradyanı maskesinin Fisher'ı her bütçede geçmesini. Üçüncüsü, off-policy'de Fisher'ın neden çöktüğünü: sinyal sınırlı değilse ikinci moment ile Fisher arasındaki orantı bozulur ve üst sınır bilgi taşımaz hale gelir.
Pratik karşılığı: seyrek post-training için tek bir skor seçilecekse o skor başlangıçtaki ortalama görev gradyanının mutlak değeridir. Fisher, görev verisi yokken kullanılacak bir vekildir ve yalnızca on-policy görevlerde güvenilirdir.
10. Açık sorular
Üç makalenin ve Bölüm 8'deki deneyin cevapsız bıraktığı altı soru var. Her biri için eldeki kanıtın neyi öngördüğünü ve hangi sonucun bu öngörüyü çürüteceğini yazdık. Öngörülerin tamamı bize aittir.
10.1 Aynı ağırlıklar hem korunacak hem değişecekse ne olur?
Bölüm 2.5'te işaret edilen gerilim bu. Elastic Weight Consolidation, Fisher'ı yüksek ağırlıkları eski görev için önemli sayar ve korur. Makale A ise on-policy güncellemenin tam da Fisher'ı yüksek ağırlıklara düştüğünü gösteriyor. Mukherjee ve arkadaşları da RL'in güncellediği alt ağın farklı veri ve algoritmalarda şansla açıklanamayacak kadar örtüştüğünü bulmuştu.
Bu üçü birlikte rahatsız edici bir öngörü veriyor: ardışık RL görevleri büyük ölçüde aynı koordinatları isteyecek. Makale C'nin ölçtüğü düşük unutma, RL görevinden çok farklı türde önceki görevler (genel bilgi, kod, talimat izleme) üzerindeydi. Birbirine benzeyen iki RL görevi arka arkaya eğitildiğinde ikinci maske birincinin sildiklerini geri isteyebilir.
Öngörü: iki RL görevinin maskeleri rastgele beklentinin çok üstünde örtüşür ve maskelerin birleşimi her iki görevde de tek tek maskelerden kötüdür.
Çürütücü sonuç: maskeler ayrık çıkar ve birleşimleri iki görevi de korur. Bu durumda maske cebiri (birleşim, kesişim, çıkarma) task vector aritmetiğinin megabayt ölçeğindeki karşılığı olur. Makale C, maskeleri birleşimle birleştirmeyi denenmemiş işler arasında sayıyor.
10.2 Fazlalığın alt sınırı nerede?
Makale C 7B altında geriliyor. Bizim 75 bin parametreli modelimizde yalnızca silerek görevi çözmek, ağırlıkların üçte birini silmeyi gerektirdi. Arada bir yerde "silmek yeter" rejiminden "silmek yetmez" rejimine geçiş var ve küçük dil modelleriyle çalışanlar için yöntemin kullanılabilirliğini bu geçişin yeri belirliyor.
İki şey bilinmiyor. Birincisi, gerileme model boyutuna mı yoksa hedef kümesinin darlığına mı bağlı: C yalnızca gate'i maskeliyor ve B'nin bulgularına göre sinyalin yoğun olduğu yer V ve O. İkincisi, base ve instruct farkı: C'nin küçük Llama modelleri instruct, ve B instruct modellerde gradyan yapısının değiştiğini gösterdi.
Öngörü: silme adayları V ve O'yu kapsayacak şekilde genişletilince 1B ile 3B arasındaki açık belirgin biçimde daralır.
Çürütücü sonuç: açık hedef kümesinden bağımsız kalır. Bu, sınırın gerçekten kapasiteyle ilgili olduğunu ve küçük modellerde silmenin serbest eğitimin yerini tutamayacağını gösterir.
10.3 Seçim ile silme birleştirilebilir mi?
Makale C'nin eğitim maliyeti, her gate ağırlığı için bir logit tutmaktan geliyor: 8B'lik modelde yaklaşık 1,9 milyar. Makale B ise aday ağırlıkları 10 saniyede buluyor. İkisi doğal olarak birbirini tamamlıyor: önce görev gradyanıyla yüz bin ile bir milyon arası aday seç, sonra yalnızca onların logitlerini eğit. C'nin yazarları da aday kümesiyle sınırlamayı çözüm olarak anıyor ama skoru belirtmiyor.
Öngörü: bin kat daha az eğitilebilir logit ile aynı doğruluk. Bölüm 6.7'deki doymuş sigmoid okuması doğruysa bu zaten örtük olarak oluyor ve aday kümesini şu an Wanda ile gürültü belirliyor.
Çürütücü sonuç: aday kümesi daraltılınca doğruluk düşer. Bu, silinmesi gereken ağırlıkların başlangıç gradyanından öngörülemediğini, eğitim sırasında ortaya çıktığını gösterir.
10.4 Seyrekliğin ne kadarı optimizer'ın eseri?
Makale A beklenen gradyanı sınırlıyor, ama gözlenen olgu (ağırlıkların çoğunun hiç değişmemesi) optimizer'dan, learning rate'ten ve sayısal hassasiyetten geçerek oluşuyor. Adam gradyan büyüklüğünü normalize ettiği için küçük gradyan tek başına küçük adım demek değildir. Bölüm 9.3'teki rastgele baseline çelişkisi de aynı yere işaret ediyor.
Bölüm 9.4'teki türetim bir ayrım öneriyor: hangi koordinatların işlevsel olarak önemli olduğu optimizer'dan bağımsız olabilir, ama kaç koordinatın ölçülebilir biçimde değiştiği learning rate'e ve eşik değerine bağlıdır.
Öngörü: aynı görev SGD ile ya da on kat büyük learning rate ile eğitildiğinde "değişmeyen ağırlık oranı" belirgin biçimde düşer, ama en çok değişen %1'lik küme büyük ölçüde aynı kalır.
Çürütücü sonuç: en çok değişen küme optimizer'a göre değişir. Bu, "RL şu alt ağı eğitir" cümlesinin "Adam ile RL şu alt ağı eğitir" diye okunması gerektiğini gösterir.
10.5 Değişiklikler okunabilir mi?
Blog yazısı bütün bir ağı okumayı deniyor ve 7 milyon parametrede sınıra dayanıyor. Oysa bu yazıdaki üç makale, post-training'in yaptığı değişikliğin çok küçük bir nesne olduğunu gösteriyor: B'de 10.000 giriş, C'de birkaç megabaytlık bir maske. Bütün modeli okumak yerine yalnızca farkı okumak, aynı aracın çok daha gerçekçi bir kullanımı olabilir. "RL bu modelde neyi değiştirdi" sorusu, on bin satırlık bir tabloya indirgenebiliyor.
C'nin stable rank ölçümü (66 ile 93) farkın ne tek bir yön ne de yapısız bir dağınıklık olduğunu söylüyor; B'nin sökme deneyi de seçilen girişlerin nedensel olduğunu gösteriyor. Geriye, bu girişlerin anlamlı birimlere (belirli nöronlar, belirli head'ler) toplanıp toplanmadığı kalıyor.
Öngörü: silinen ya da seçilen ağırlıklar az sayıda nöron ve head'de yoğunlaşır ve bunların bir kısmı adlandırılabilir bir işlev taşır.
Çürütücü sonuç: ağırlıklar birimlere yayılmıştır ve hiçbir birim tek başına anlam taşımaz. Bu durumda seyreklik yorumlanabilirlik getirmez.
10.6 Yeni bir yetenek için ne gerekir?
Bu yazıdaki kanıtın neredeyse tamamı var olan yeteneğin yeniden ağırlıklandırılmasıyla ilgili. Modele gerçekten yeni bir şey öğretmek hakkında üç ipucu var. Bizim deneyde görev gradyanı maskesi %1 bütçeyle yeni tokeni öğretti, Fisher maskesi öğretemedi. Makale B'nin zor SFT görevinde seyrek B, tam LoRA'nın yedi puan gerisinde kaldı. Makale C'de distillation, RL'in dört ile yedi katı silme gerektirdi.
Öngörü: off-policy öğrenmede seyrek güncelleme mümkündür ama gereken bütçe on-policy'nin en az on katıdır ve seçim görev gradyanıyla yapılmak zorundadır.
Çürütücü sonuç: gerçek modellerde off-policy öğrenme de binde birin altında bir bütçeyle tam eğitime yetişir. Bu, seyrekliğin on-policy'ye özgü olmadığını ve Makale A'nın çerçevesinin gereğinden dar olduğunu gösterir.
11. Bu soruları sınayacak altı deney
Bölüm 9 ve 10'daki her ayrışma ve soru için, cevabı tek başına verebilecek en küçük deneyi tanımladık. Hepsi aynı taban düzeneği paylaşıyor, böylece sonuçlar birbiriyle karşılaştırılabilir.
Ortak düzenek. Qwen2.5-1.5B base, MATH üzerinde GRPO, GSM8K ve MATH-500'de değerlendirme. Bu, Makale B'nin en keskin sonucu verdiği ayar: baz model %9,5, tam LoRA %62,8, aradaki açıklık herhangi bir yöntem farkını görünür kılacak kadar büyük. Model 16 GB'lık tek bir GPU'ya sığar.
| No | Sınadığı soru | Kollar | Karar ölçütü |
|---|---|---|---|
| D1 | Rastgele seyrek seçim gerçekten öğrenmiyor mu, yoksa learning rate mi yetmiyor? (9.3, Ayrışma 1) | Tüm ağırlıkların rastgele %0,05'i ile görev gradyanıyla seçilmiş %0,05'i; her biri dört learning rate'te (1e-6, 1e-5, 1e-4, 1e-3) | Rastgele maske herhangi bir learning rate'te tam eğitimin yarısını geçerse A ve B'nin iddiası learning rate'e bağlıdır |
| D2 | Gate mi, V ve O mu; silmek mi, eğitmek mi? (9.3, Ayrışma 2) | Eşit sayıda gerçek ağırlık üzerinde dört kol: gate'i eğit, V ve O'yu eğit, gate'i sil, V ve O'yu sil | 2x2 tablo iki etkiyi ayırır: işlemin etkisi (satırlar) ve hedefin etkisi (sütunlar) |
| D3 | Erken katman yoğunlaşması işlevsel mi, ölçek yan etkisi mi? (5.6) | B'nin global seçimi ile matris başına gradyan normuna bölünmüş seçim, aynı bütçede | Normalize seçim bütçeyi katmanlara yayar ve doğruluk düşmezse, yoğunlaşma bir yan etkidir |
| D4 | Fisher maskesi off-policy öğrenmede gerçek modelde de çöküyor mu? (8.4) | Modelin bilmediği bir format ya da bilgi üzerinde SFT; Fisher, görev gradyanı ve rastgele maske, %0,1 bütçe | Fisher maskesi rastgelenin altında kalırsa 8.4'teki bulgu gerçek ölçekte geçerlidir |
| D5 | Ardışık görevlerin maskeleri çakışıyor mu? (10.1) | İki RL görevi sırayla; her biri için ayrı maske; maskelerin örtüşmesi, birleşimi ve ardışık eğitim | Örtüşme rastgelenin on katından fazlaysa ve birleşim iki görevi de bozuyorsa, düşük unutma iddiası benzer görevlere taşınmaz |
| D6 | Deletion Tuning'de fiilen kaç logit eğitiliyor? (6.7, 10.3) | Yöntemin 0.5B'de yeniden uygulanması; logit histogramı ve maske değişimlerinin adım adım kaydı; logitleri yalnızca görev gradyanıyla seçilmiş adaylara sınırlayan ikinci kol | İşaret değiştiren logitlerin tamamı başlangıçta eşiğe yakın olanlarsa, aday kümesini gürültü belirliyordur |
Öncelik sırası D1, D4, D2. D1 en ucuz olanı ve iki makalenin ana iddiasının kapsamını belirliyor. D4, bu yazının kendi bulgusunu gerçek ölçekte sınıyor. D2 en bilgilendirici olanı ama dört kol gerektiriyor.
D2 için bir uygulama notu: Makale B'nin ölçümleri LoRA-B girişleri üzerinde, C'ninkiler gerçek ağırlıklar üzerinde. Dört kolun karşılaştırılabilir olması için hepsinin gerçek ağırlıklar üzerinde tanımlanması ve seçimin her modül içinde ayrı yapılması gerekir; aksi halde 9.3'teki ölçek sorunu deneyin içine taşınır.
12. Bu yazının sınırları
Okuma yöntemi. Üç makale tam metin olarak ama metin çıkarımı üzerinden okundu. Şekillerin içindeki değerler (A'nın Şekil 3'ü, C'nin Şekil 2 ve 3'ü) yalnızca metinde geçtiği kadarıyla alındı. B'deki iç tutarsızlıklar orijinal PDF'te gözle teyit edilmedi.
Bilinmeyenler. C'nin rastgele baseline'ının (MTH) learning rate'i ve hangi modülleri kapsadığı bilinmiyor; 9.3'teki birinci açıklama bu bilgiye bağlı. C'nin maske başlangıcının ayrıntıları (Denklem 8) elimizde olmadığı için doymuş sigmoid okuması nitel kaldı.
Deneyimizin ölçeği. Bölüm 8'deki model 75 bin parametreli, attention içermiyor ve yapay bir dilde eğitildi. Sonuçları mekanizmalar hakkında fikir verir, gerçek modeller hakkında hüküm vermez. Seed sayısı üç; güven aralığı hesaplanmadı.
Yorumlar. "Bizim okumamız", "hipotez" ve "öngörü" diye işaretlenen her şey sınanmamış çıkarımdır. 9.4'teki türetim sezgiseldir; Adam'ın momentum ve epsilon terimlerini, gradyanlar arası korelasyonu yok sayar.
Arka plan kaynakları. Bölüm 2 ve 3'teki klasik çalışmalar genel bilgiden aktarıldı ve bu yazı için yeniden okunmadı. Yayın öncesi arXiv bağlantıları ve başlıkları kontrol edildi.
Blog yazısı. Hakemli değildir; kullandığı Astra modeli hakkında yazının verdiğinden fazla bilgimiz yoktur.
Sözlük
| Terim | Tek cümleyle | İlk geçtiği yer |
|---|---|---|
| Post-training | Ön eğitimden sonra modele yapılan her türlü eğitim: SFT, RL, distillation | 2.2 |
| On-policy, off-policy | Eğitim verisi modelin kendi ürettiği cevaplardan geliyorsa on-policy, dışarıdan geliyorsa off-policy | 2.2 |
| GRPO | Aynı soruya üretilen bir grup cevabı birbirine göre ödüllendiren RL algoritması | 2.2 |
| Residual stream | Her katmanın okuduğu ve üstüne yazdığı, model boyunca akan ortak vektör | 2.3 |
| Projeksiyon | Bir bloğun içindeki doğrusal katmanların her biri: Q, K, V, O, gate, up, down | 2.3 |
| LoRA | Dondurulmuş ağırlığın yanına eklenen düşük ranklı, eğitilebilir düzeltme | 2.4 |
| Fisher | Bir parametre oynatıldığında modelin çıktı dağılımının ne kadar değiştiğinin ölçüsü | 2.5 |
| Skor | Örneklenen cevabın log-olasılığının bir parametreye göre türevi | 2.5 |
| Maske | Hangi ağırlıkların eğitileceğini ya da silineceğini söyleyen 0-1 tablosu | 3.2 |
| Baseline | Bir yöntemin kıyaslandığı referans yöntem; RL'de ayrıca ödülden çıkarılan ortalama | 4.3 |
| Circuit | Makale B'de skorla seçilen giriş kümesi; genel anlamıyla belirli bir işi yapan ağırlık alt kümesi | 5.2 |
| Base, instruct | Yalnızca ön eğitim görmüş model; talimat izlemek üzere ayrıca eğitilmiş model | 5.3 |
| pass@k | k denemeden en az birinin doğru olma oranı | 6.3 |
| Stable rank | Bir matrisin enerjisinin kaç yöne yayıldığını söyleyen, gürültüye dayanıklı rank ölçüsü | 6.5 |
Kaynakça
Temel kaynaklar
Zhang, Mukherjee, Peng. Understanding LLM Parameter Update Sparsity through the Lens of Fisher. arXiv:2609.36262, 2026.
Sehanobish, Lovering. Not How Many, But Which: Parameter Placement in Low-Rank Adaptation. arXiv:2605.12207, 2026.
Lu, Yang, Lasby, Pote, Ioannou, Ren. The Surprising Effectiveness of Deleting Weights in LLM Post-Training. NeurIPS 2026, arXiv:2611.10866.
Takehi, Teoh, Zhang, Khattab. Sparks of Weight-Space Programming. MIT CSAIL blog, 2 Kasım 2026.
Doğrudan öncüller
Mukherjee, Yuan, Hakkani-Tür, Peng. Reinforcement Learning Finetunes Small Subnetworks in Large Language Models. NeurIPS 2025.
Zhu ve arkadaşları. The Path Not Taken: RLVR Learns Off the Principals. NeurIPS 2026. (Makale C'nin atıfından.)
Adewuyi ve arkadaşları. Multiple Ticket Hypothesis. 2026. (Makale C'nin atıfından.)
Pruning ve maske öğrenme
LeCun, Denker, Solla. Optimal Brain Damage. NIPS 1989.
Hassibi, Stork. Second Order Derivatives for Network Pruning: Optimal Brain Surgeon. NIPS 1993.
Han ve arkadaşları. Learning both Weights and Connections for Efficient Neural Networks. 2015.
Lee, Ajanthan, Torr. SNIP: Single-shot Network Pruning based on Connection Sensitivity. 2018.
Frankle, Carbin. The Lottery Ticket Hypothesis. 2018.
Mallya, Davis, Lazebnik. Piggyback: Adapting a Single Network to Multiple Tasks by Learning to Mask Weights. 2018.
Zhou, Lan, Liu, Yosinski. Deconstructing Lottery Tickets: Zeros, Signs, and the Supermask. 2019.
Ramanujan ve arkadaşları. What's Hidden in a Randomly Weighted Neural Network?. 2019.
Malach ve arkadaşları. Proving the Lottery Ticket Hypothesis: Pruning is All You Need. 2020.
Zhao ve arkadaşları. Masking as an Efficient Alternative to Finetuning for Pretrained Language Models. 2020.
Sanh, Wolf, Rush. Movement Pruning: Adaptive Sparsity by Fine-Tuning. 2020.
Guo, Rush, Kim. Parameter-Efficient Transfer Learning with Diff Pruning. 2020.
Sung, Nair, Raffel. Training Neural Networks with Fixed Sparse Masks. 2021.
Sun, Liu, Bair, Kolter. A Simple and Effective Pruning Approach for Large Language Models. 2023.
Weight space ve model düzenleme
Kirkpatrick ve arkadaşları. Overcoming Catastrophic Forgetting in Neural Networks. 2017.
Li ve arkadaşları. Measuring the Intrinsic Dimension of Objective Landscapes. 2018.
Aghajanyan, Zettlemoyer, Gupta. Intrinsic Dimensionality Explains the Effectiveness of Language Model Fine-Tuning. 2020.
Meng ve arkadaşları. Locating and Editing Factual Associations in GPT. 2022.
Ilharco ve arkadaşları. Editing Models with Task Arithmetic. 2022.
Lindner ve arkadaşları. Tracr: Compiled Transformers as a Laboratory for Interpretability. 2023.
Arditi ve arkadaşları. Refusal in Language Models Is Mediated by a Single Direction. 2024.